
文字驱动的声音生成
用文字描述声音,让 2G 生成可编辑并作为采样播放的音频。
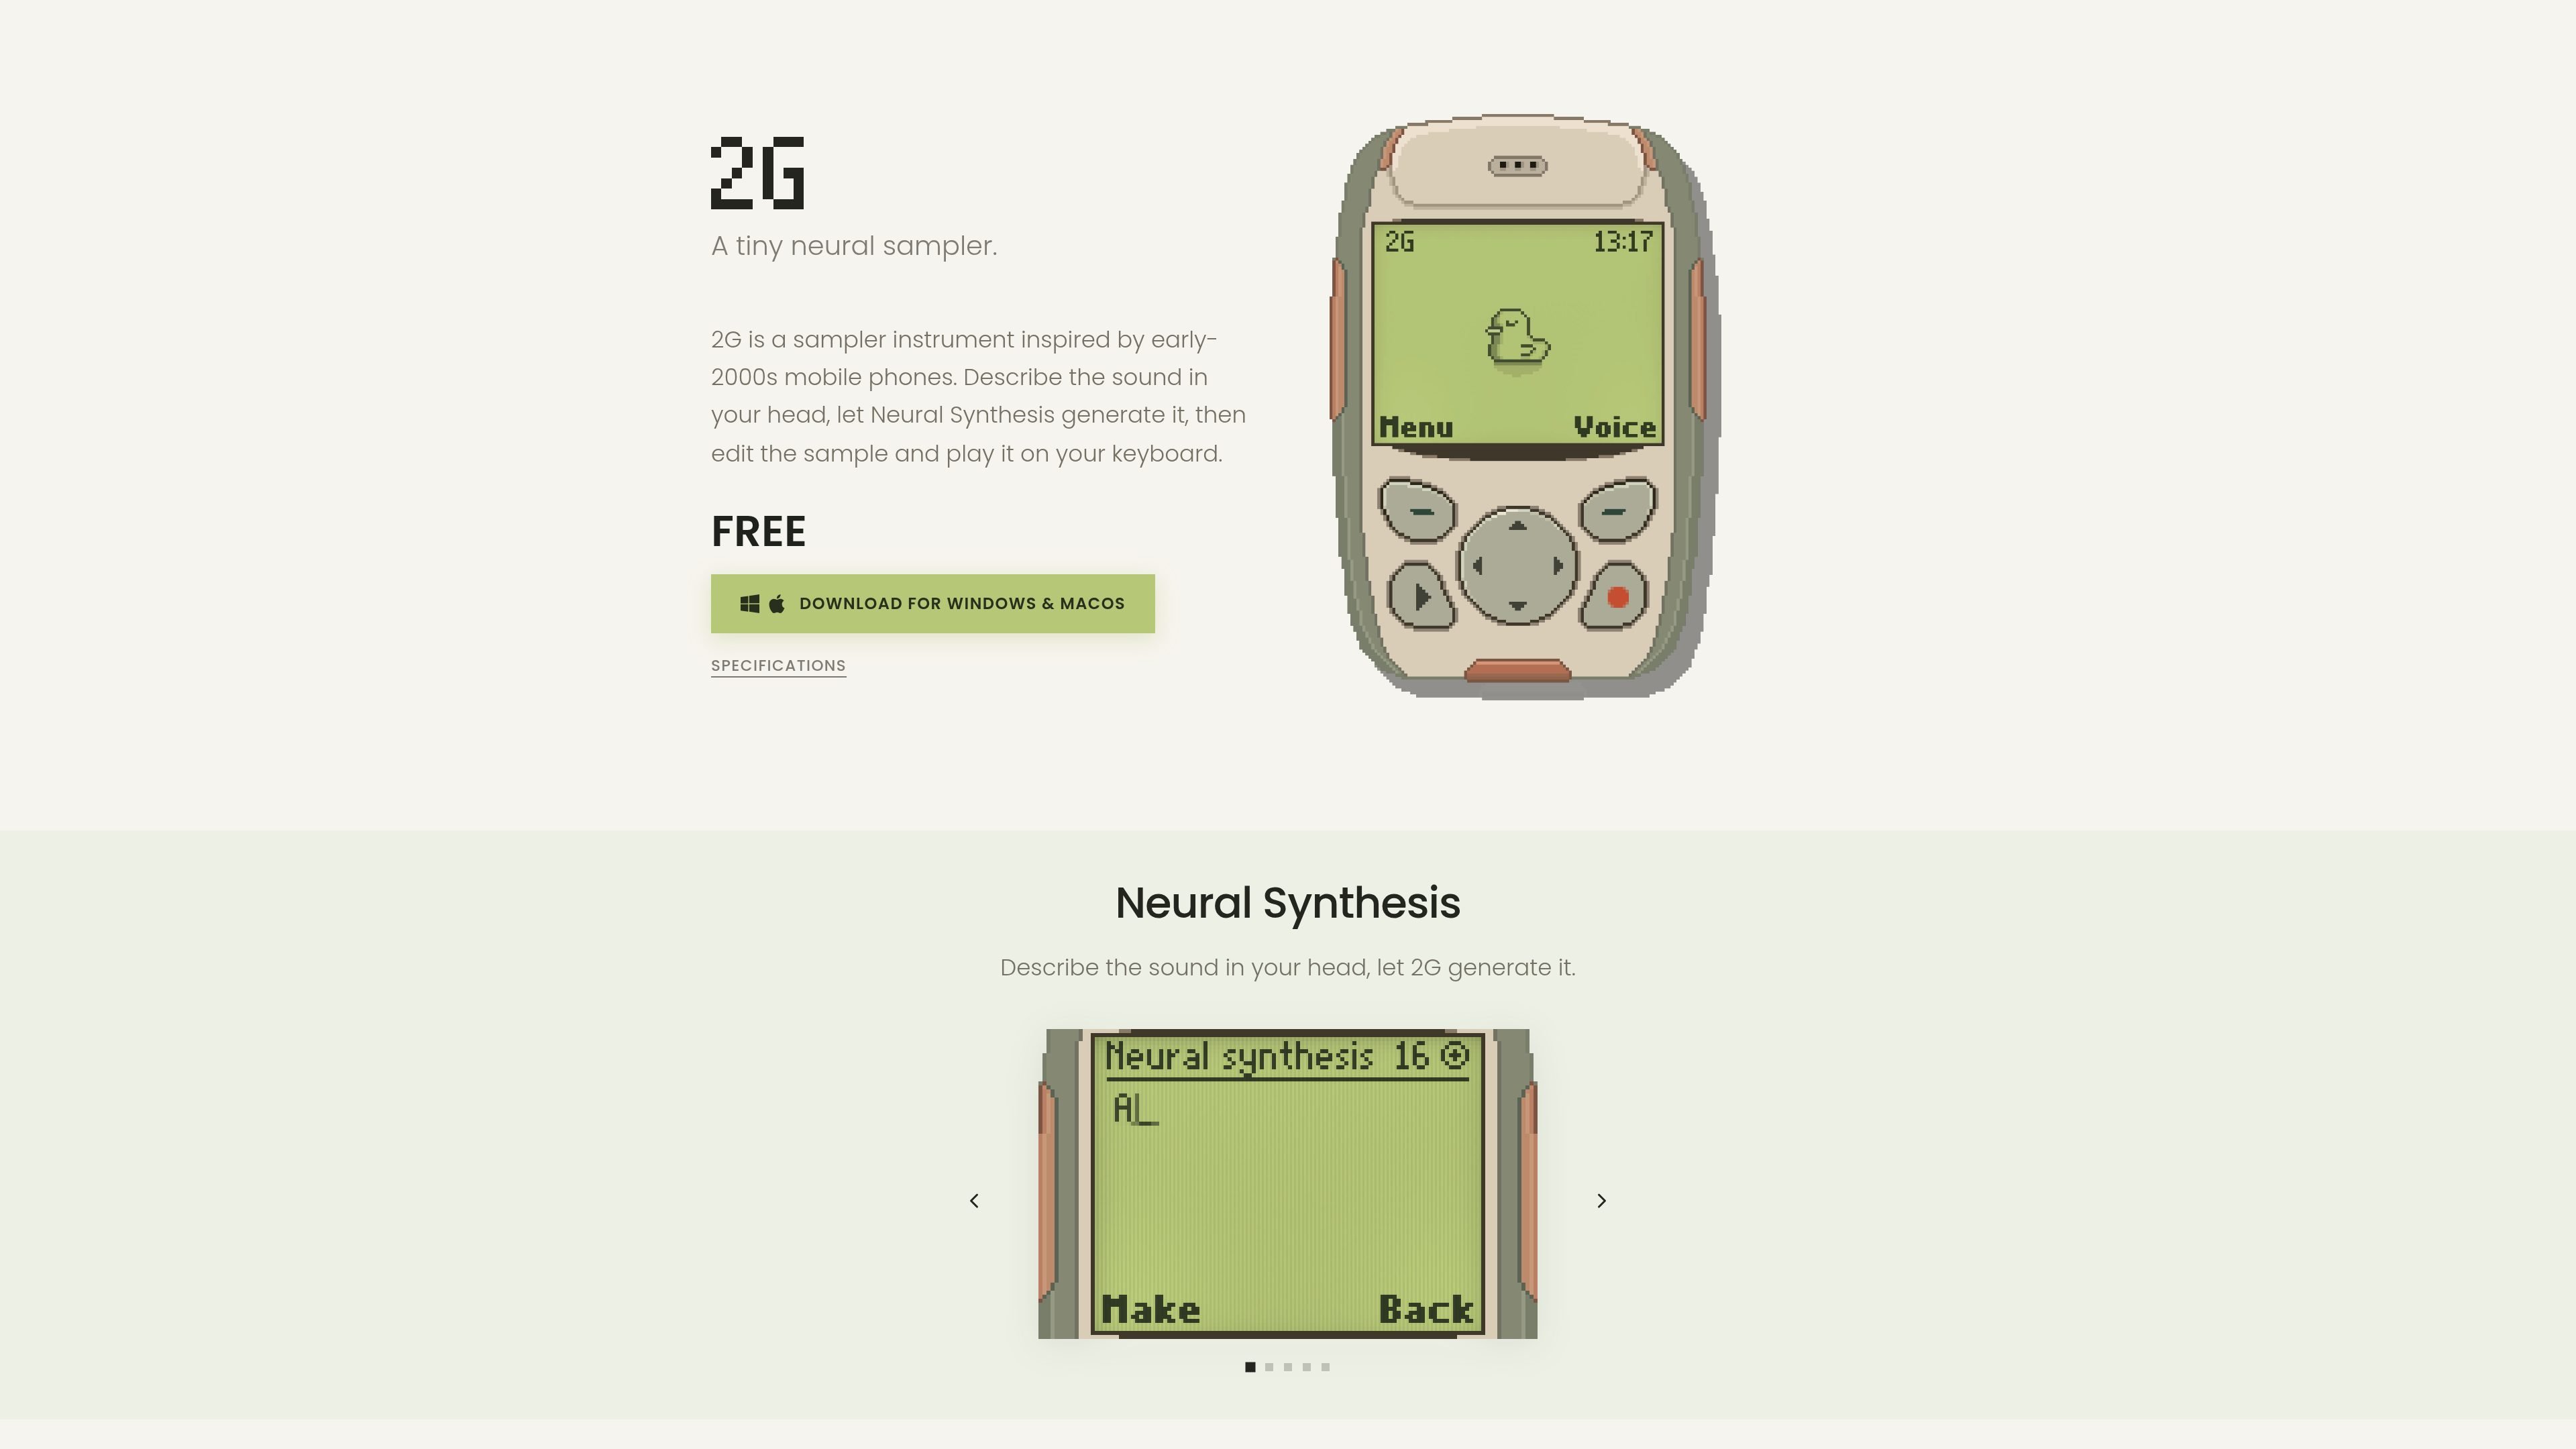
2G 是 Scrap Brain Audio 推出的一款小型采样器乐器,灵感来自 2000 年代初的手机。其核心工作流将基于文本的 Neural Synthesis 与采样编辑结合起来:描述声音、生成声音、调整结果,然后通过键盘演奏。它也支持导入音频,方便不想生成新素材的用户使用。
这款乐器围绕一种刻意受限的手持手机声音特质设计。其 16 kHz 单声道模式、窄频带扬声器模型和四声部共享物理模型会影响声音在播放时的响应;循环和根音分析则有助于将短源文件转换为可演奏的延音采样。
用文字描述声音,让 2G 生成可编辑并作为采样播放的音频。
分析音色、音量和颤音,以找出合适的循环区域;通过交叉淡化平滑过渡,并在可用时提供最多三个候选结果。
测量整个采样中的音高一致性,在播放时修正检测到的微调差异,并将没有明显音高的采样标记为无音高。
裁剪采样,并使用 Attack、Release、Brightness、Detune、Noise、Quality 和 Formant 控制项塑造其响应。
模拟小型移动设备扬声器的窄频率范围、共振、振膜位移和与热量相关的压缩效果。通过开关可以绕过 16 kHz 单声道处理。
Windows 包含 VST3 和独立版本;macOS 包含 AU、VST3 和独立版本。
用文字描述一个一次性音色或短音乐声音,生成一个起点,然后进行裁剪和塑形,以便通过键盘演奏。
导入短 WAV、AIFF、FLAC 或 MP3 文件,使用根音和循环分析进行准备,并在不依赖生成服务的情况下进行演奏。
使用小扬声器模拟和 16 kHz 单声道模式,以刻意窄化、类似手机的播放特质试听声部。
生成后完全使用已保存的生成声音或本地采样工作,包括在无法联网时进行离线编辑和播放。
2G 可使用 Neural Synthesis 根据文字描述生成音频。生成的结果随后可以在乐器中编辑并作为采样播放。
可以。你可以导入、编辑和播放自己的音频,而无需生成任何内容。这些操作不消耗点数,也不要求订阅 Studio。
2G 可导入 WAV、AIFF、FLAC 和 MP3 文件,每个文件大小最多 20 MB、时长最多 10 秒。原始源文件不会被修改。
Neural Synthesis 和点数验证需要互联网连接。本地采样可以离线播放和编辑。
生成的声音可免费用于个人和商业音乐,但不得将其重新打包或作为独立采样或采样库转售。