
决策评分
该模型专门用于评估决策,并返回软件可在后续逻辑中使用的结构化输出。
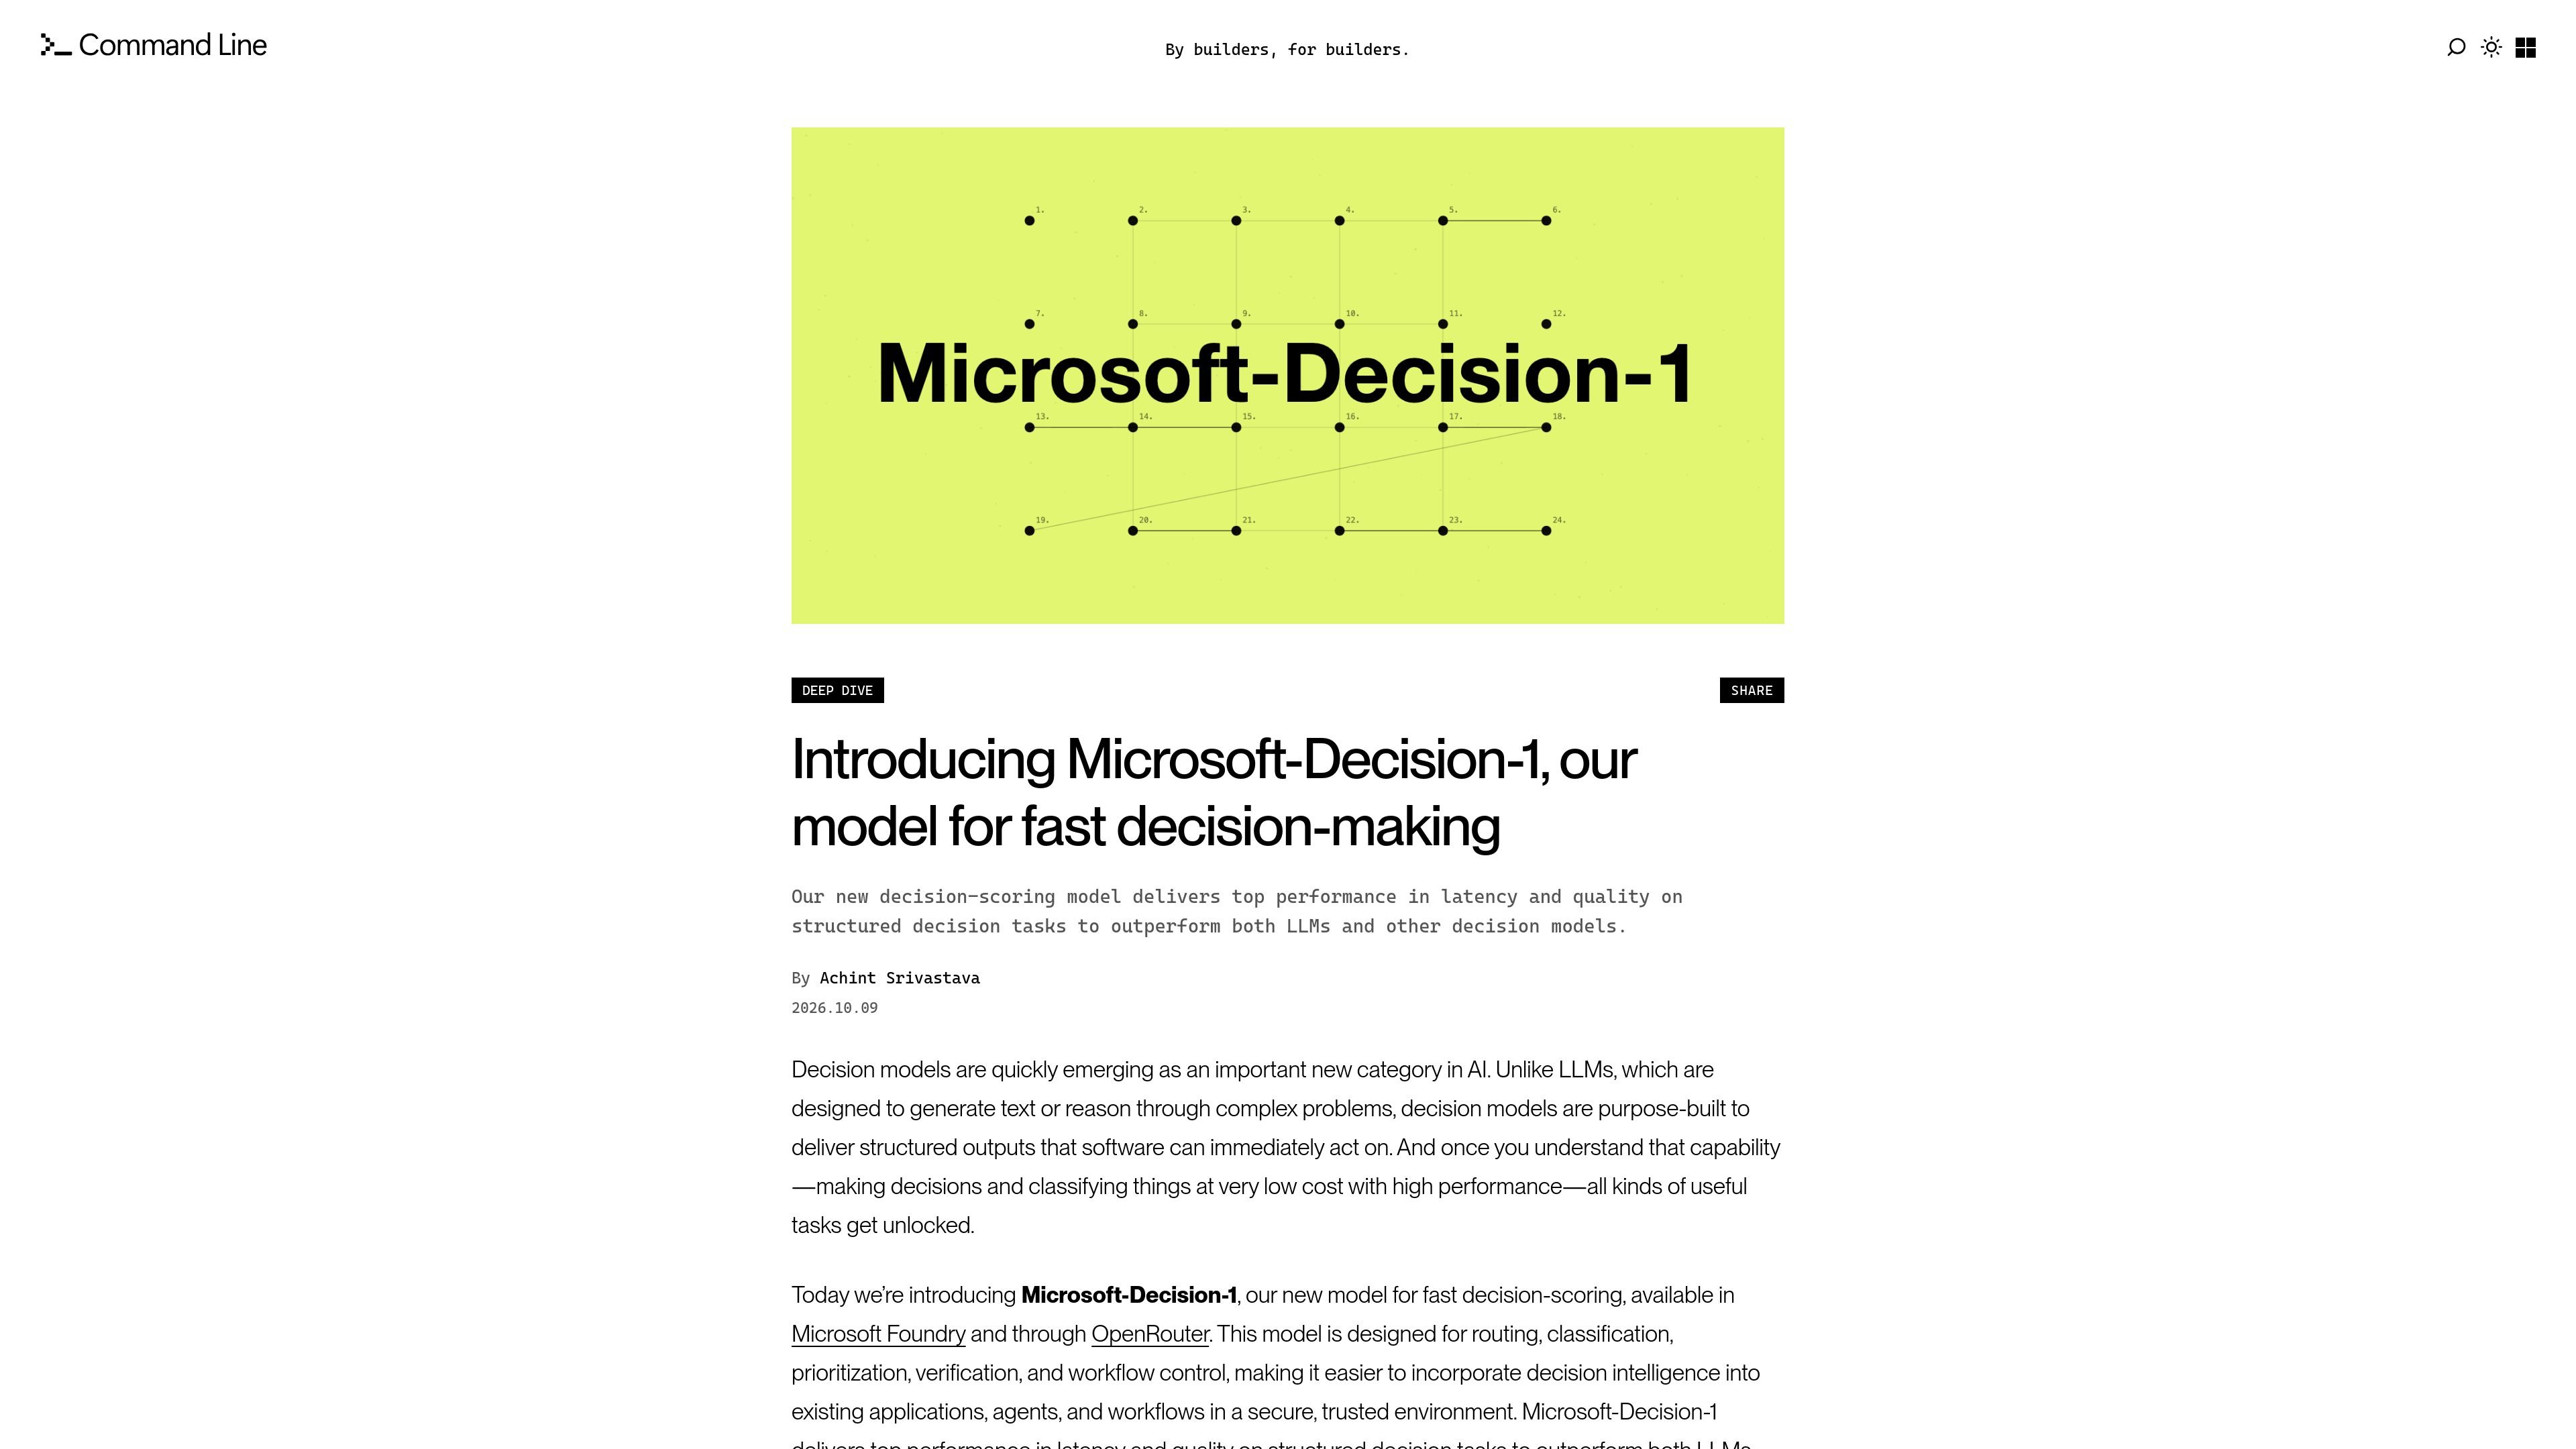
Microsoft-Decision-1 是 Microsoft 推出的决策评分模型,用于结构化决策任务。与主要用于生成文本或处理复杂问题的语言模型不同,它旨在生成软件可以直接据此采取行动的结构化输出。
该模型面向路由、分类、优先级排序、验证和工作流控制。Microsoft 表示,该模型可通过 Microsoft Foundry 和 OpenRouter 使用,并报告了侧重准确性、延迟和校准的基准测试结果。现有来源未提供详细的设置说明、输出格式、定价和部署限制。
该模型专门用于评估决策,并返回软件可在后续逻辑中使用的结构化输出。
Microsoft 将该模型定位为可将输入整理到不同类别中,从而支持自动化分类工作流。
该模型面向低延迟决策任务设计,公告报告称,在其基准测试中,其实测性能快于参与比较的模型。
该模型可支持路由和工作流控制决策,帮助软件系统选择路径或操作。
公告列出的使用场景包括优先级排序和验证,使应用能够对项目进行排序,或在自动化流程中检查决策。
Microsoft-Decision-1 通过 Microsoft Foundry 和 OpenRouter 提供,这些是文档中列出的模型使用入口。
使用模型的结构化决策,将传入的请求、记录或事件导向适当的软件路径或处理程序。
在应用需要将输入分配到预定义类别后再执行后续操作时,应用模型生成的分类结果。
对项目进行排名或排序,使系统能够优先关注或处理优先级较高的案例。
增加验证步骤,在分类结果或其他结构化决策进入自动化工作流之前对其进行检查。
将决策输出用作应用或智能体内部进行分支、门控或其他工作流逻辑的控制信号。
根据产品公告,Microsoft-Decision-1 可通过 Microsoft Foundry 和 OpenRouter 使用。
该模型用于结构化决策任务,包括路由、分类、优先级排序、验证和工作流控制。来源未提供设置说明或详细的输出架构。
Microsoft 将其描述为一种决策评分模型,可生成软件能够据此采取行动的结构化输出,而不是主要用于生成文本的通用语言模型。
公告报告了一项涵盖 36 个基准、近 150,000 个与训练数据隔离的问题的对比结果。报告称其在该对比中具有最快的实测延迟,但现有来源未提供完整的方法说明或部署规格。

Grok 4.7 是 xAI 推出的软件开发与知识工作模型,支持长时间编码任务和专业分析,可通过 Grok Build、Cursor、Grok API 等平台使用,输入每百万 token 起价 2 美元,输出每百万 token 起价 6 美元。
AakarDev AI 帮助团队在一个仪表板中管理 AI provider 访问、项目级设置、日志和分析,支持 BYOK 工作流,并涵盖 OpenAI、Google Gemini、Anthropic、Groq、Mistral AI 和 Perplexity AI。

BookAI允许您通过简单提供书名和作者与您的书籍进行AI聊天。

Skills Janitor 是一组托管于 GitHub 的斜杠命令,用于审计、跟踪和管理 Claude Code 与 OpenAI Codex skills。可查找重复项、损坏链接和未使用的 skills,并用独立命令清理。

FeelFish 是一款面向 AI 辅助小说写作的 PC 客户端,帮助小说作者规划人物与场景、撰写和修改长篇内容,并管理故事上下文。支持免费版和付费方案,兼容多种大模型服务商。

Benchspan 是一款 AI agent 安全平台,可发现 agent、实时阻止提示注入和数据外泄,并支持上线前红队测试,适用于生产环境中的 agent 团队,提供 Python 和 TypeScript SDK。