

智能体工作流执行
M3.1 Flash 专为多步骤规划、链式工具调用以及企业 SaaS 工作流中的端到端执行而构建,涵盖销售、营销、运营、客户服务、财务和人力资源等场景。
MiniMax M3.1 Flash 是一款专注于智能体任务、编程、电脑操作和网络安全的语言模型。它旨在超越生成响应,通过跨多个步骤进行规划、调用工具、在软件环境中操作,并完成需要持续执行的工作流。
该模型面向构建 AI 智能体、编程助手、自动化系统和安全工作流的开发者与团队。它可通过 MiniMax API、M Plan 和 MiniMax Code 使用,并依据输入、输出和缓存输入 Token 用量采用公开定价。MiniMax 报告称,与上一代模型相比,其智能体任务的总体使用成本降低了 70%;定价页面则列出了当前的每 Token 费率。
M3.1 Flash 专为多步骤规划、链式工具调用以及企业 SaaS 工作流中的端到端执行而构建,涵盖销售、营销、运营、客户服务、财务和人力资源等场景。
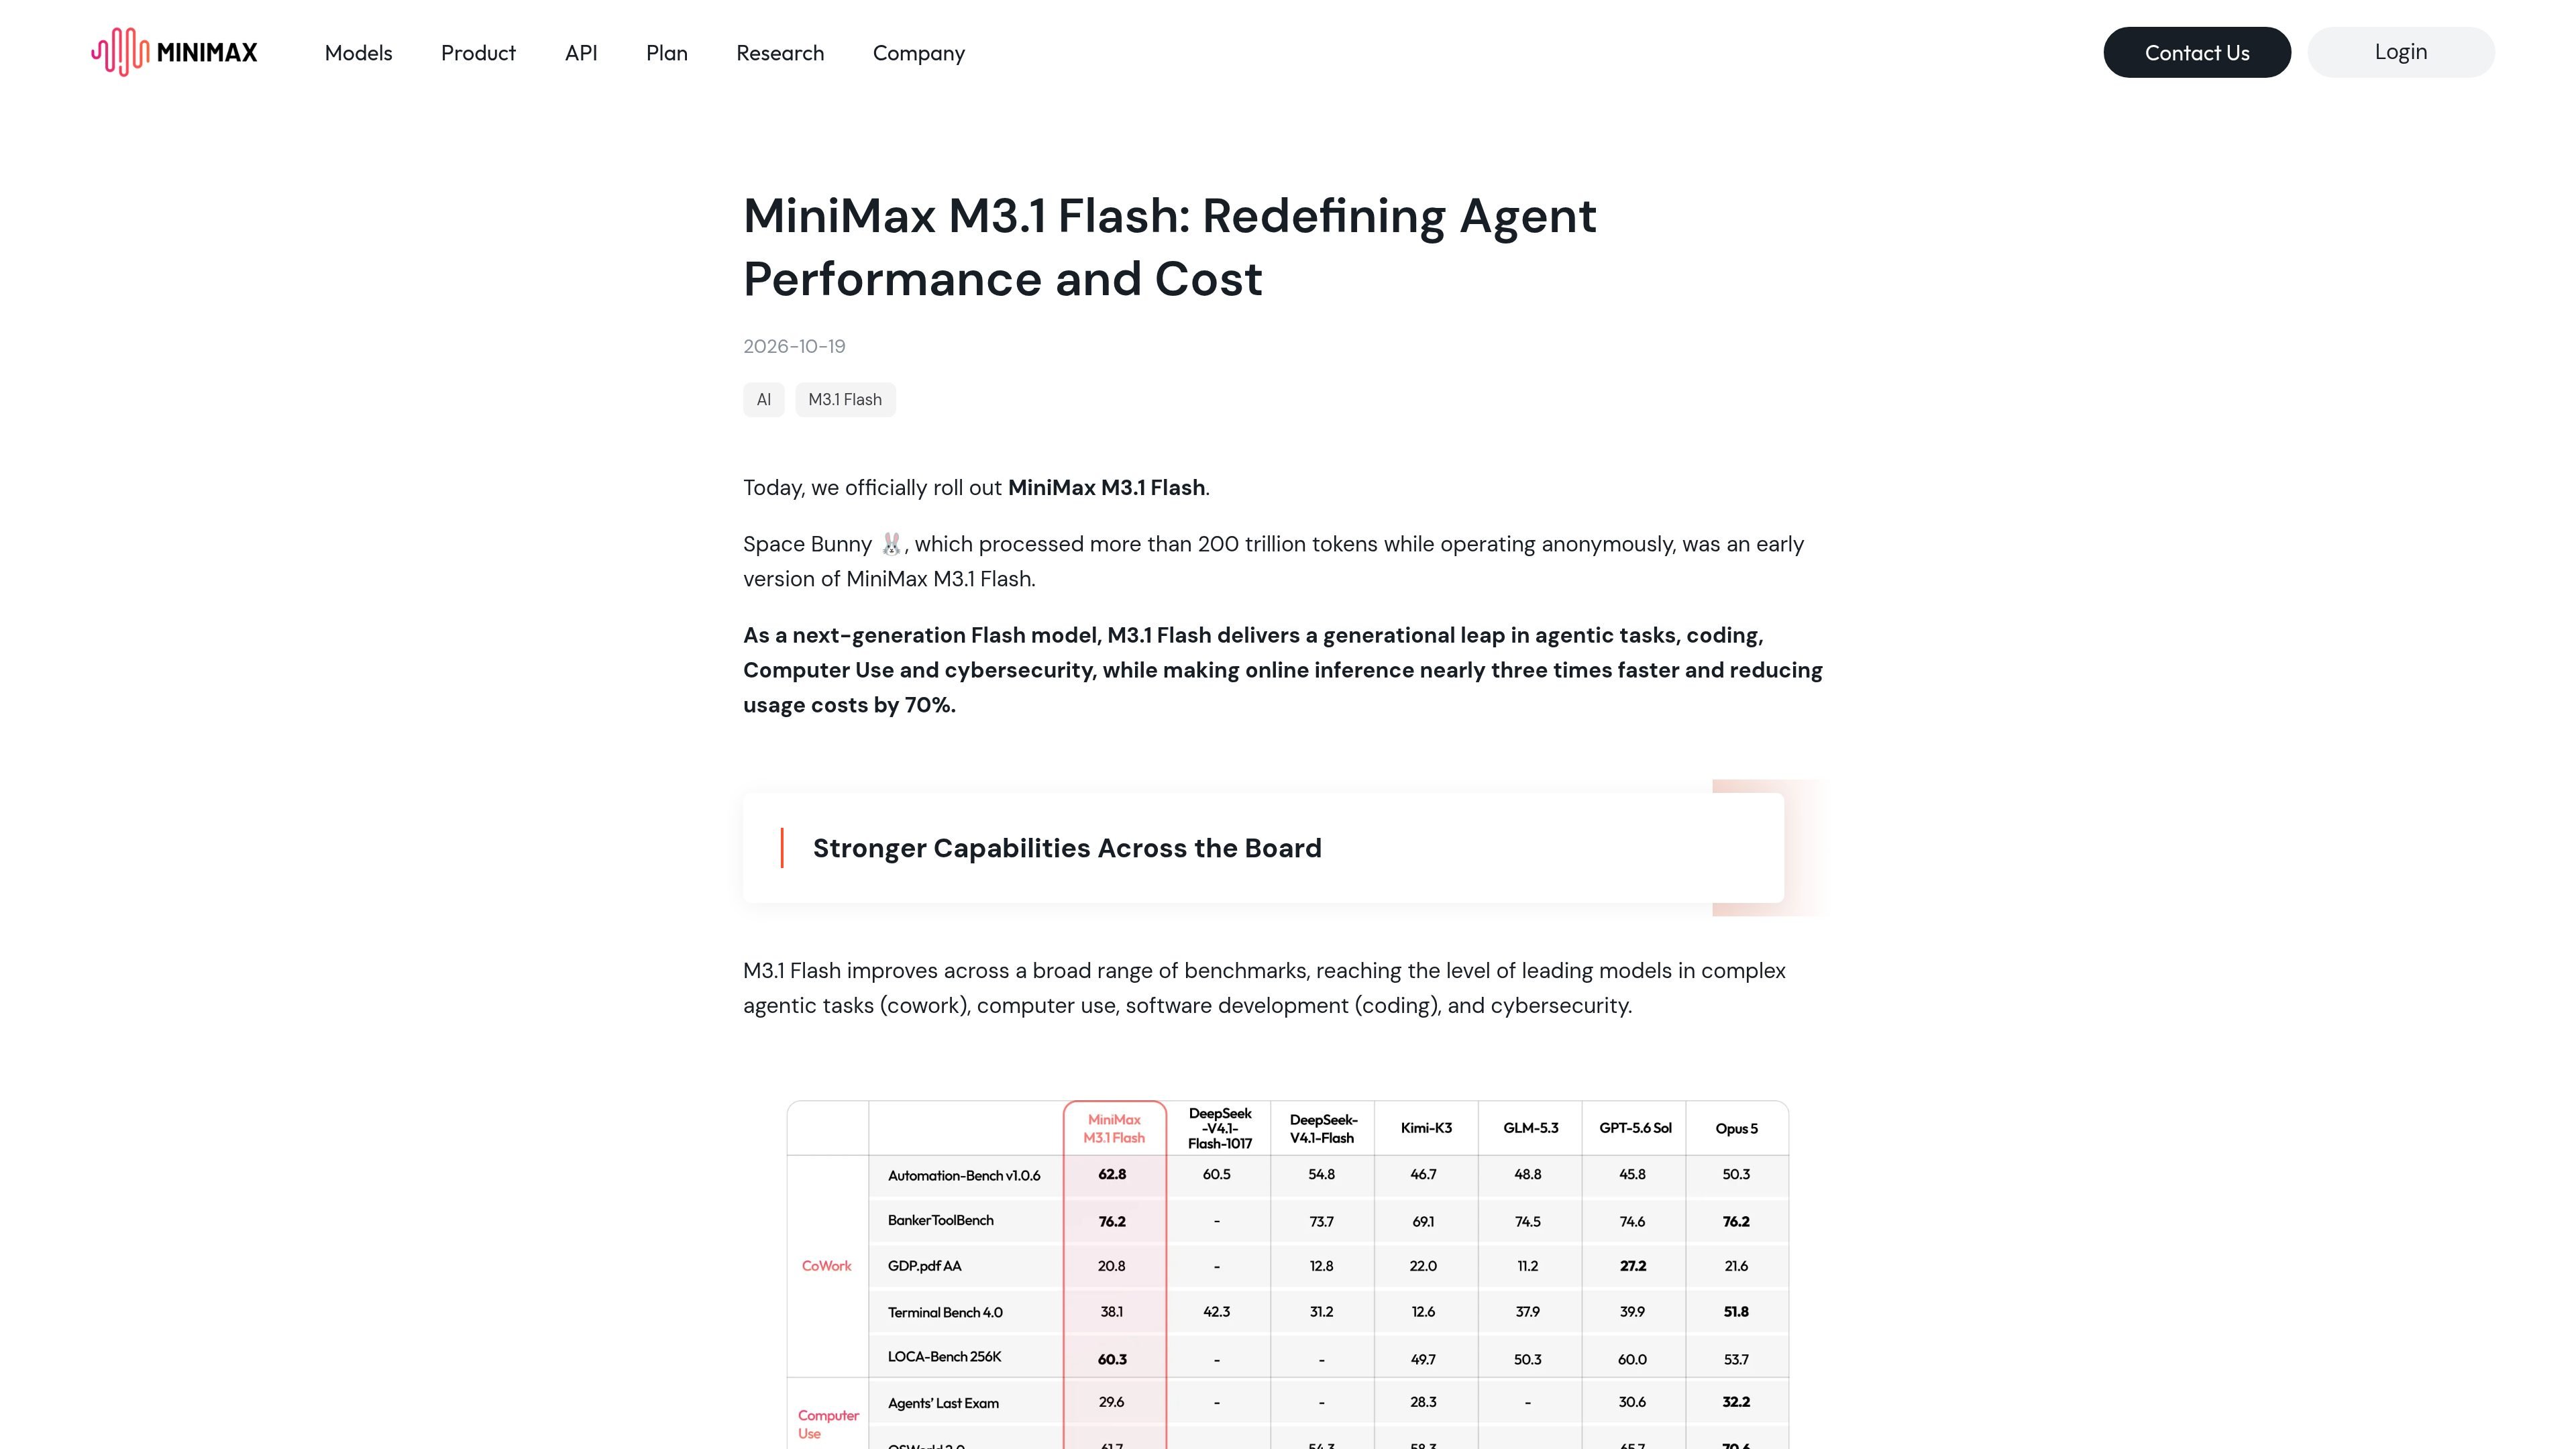
该模型支持涉及理解代码、实现功能、修复问题以及通过测试验证变更的复杂软件任务。MiniMax 报告称,其在 DeepSWE v1.1 上的得分为 73.7%。
该模型针对跨应用电脑操作和专业工作任务进行评测,在 OSWorld V2 和 Agents’ Last Exam 上报告的得分分别为 61.7 和 29.6。
M3.1 Flash 面向漏洞发现与验证、代码审计、漏洞修补、渗透测试、恶意软件分析和逆向工程。MiniMax 报告称,其 CyberGym 得分为 82%。
该模型通过提高稀疏性来优化推理效率。来源报告称,其日常输出速度超过每秒 200 个 Token,中位速度超过每秒 170 个 Token。
列示费率为:每 100 万输入 Token $0.15、每 100 万输出 Token $0.60、每 100 万缓存输入 Token $0.015,便于估算 Token 用量。
自动化跨 SaaS 应用的多步骤工作,例如在销售、营销、运营、客户服务、财务或人力资源工作流中协调记录和文档。该模型旨在持续保持任务一致性,同时进行链式工具调用。
将该模型用作编程助手,用于功能开发、错误修复、代码仓库理解以及基于测试的验证。其报告的 DeepSWE 结果涉及需要跨多个步骤自主执行的软件任务。
构建能够跨多个界面与桌面或 Web 应用交互的智能体,而不是停留在文本指令层面。适用于智能体必须操作软件并产出完整结果的工作流。
通过代码审查和以漏洞为重点的工作流支持安全团队,包括漏洞发现、修补、渗透测试、恶意软件分析和逆向工程。
运行高容量智能体工作负载,在此类场景中,响应吞吐量和 Token 成本会实质性影响运营支出。公开的定价和速度数据有助于估算重复性任务或长时间运行任务的成本。
MiniMax M3.1 Flash 可通过 MiniMax API、M Plan 和 MiniMax Code 使用。来源指出模型权重将于稍后发布,因此目前没有文档说明可下载模型权重。
它面向需要规划、工具使用、多步骤执行、编程、电脑交互或网络安全相关分析的智能体工作流。来源未提供外部工具或集成的完整兼容性列表。
公开的 API 费率为:每 100 万输入 Token 收费 $0.15,每 100 万输出 Token 收费 $0.60,每 100 万缓存输入 Token 收费 $0.015。定价页面将这些标识为 MiniMax-M3.1-Flash 的列示费率;实际账单根据 Token 用量计算。
MiniMax 报告称,在部分使用场景中,日常输出速度超过每秒 200 个 Token,中位速度超过每秒 170 个 Token。来源未保证每个请求或工作负载都具有固定响应速度。