

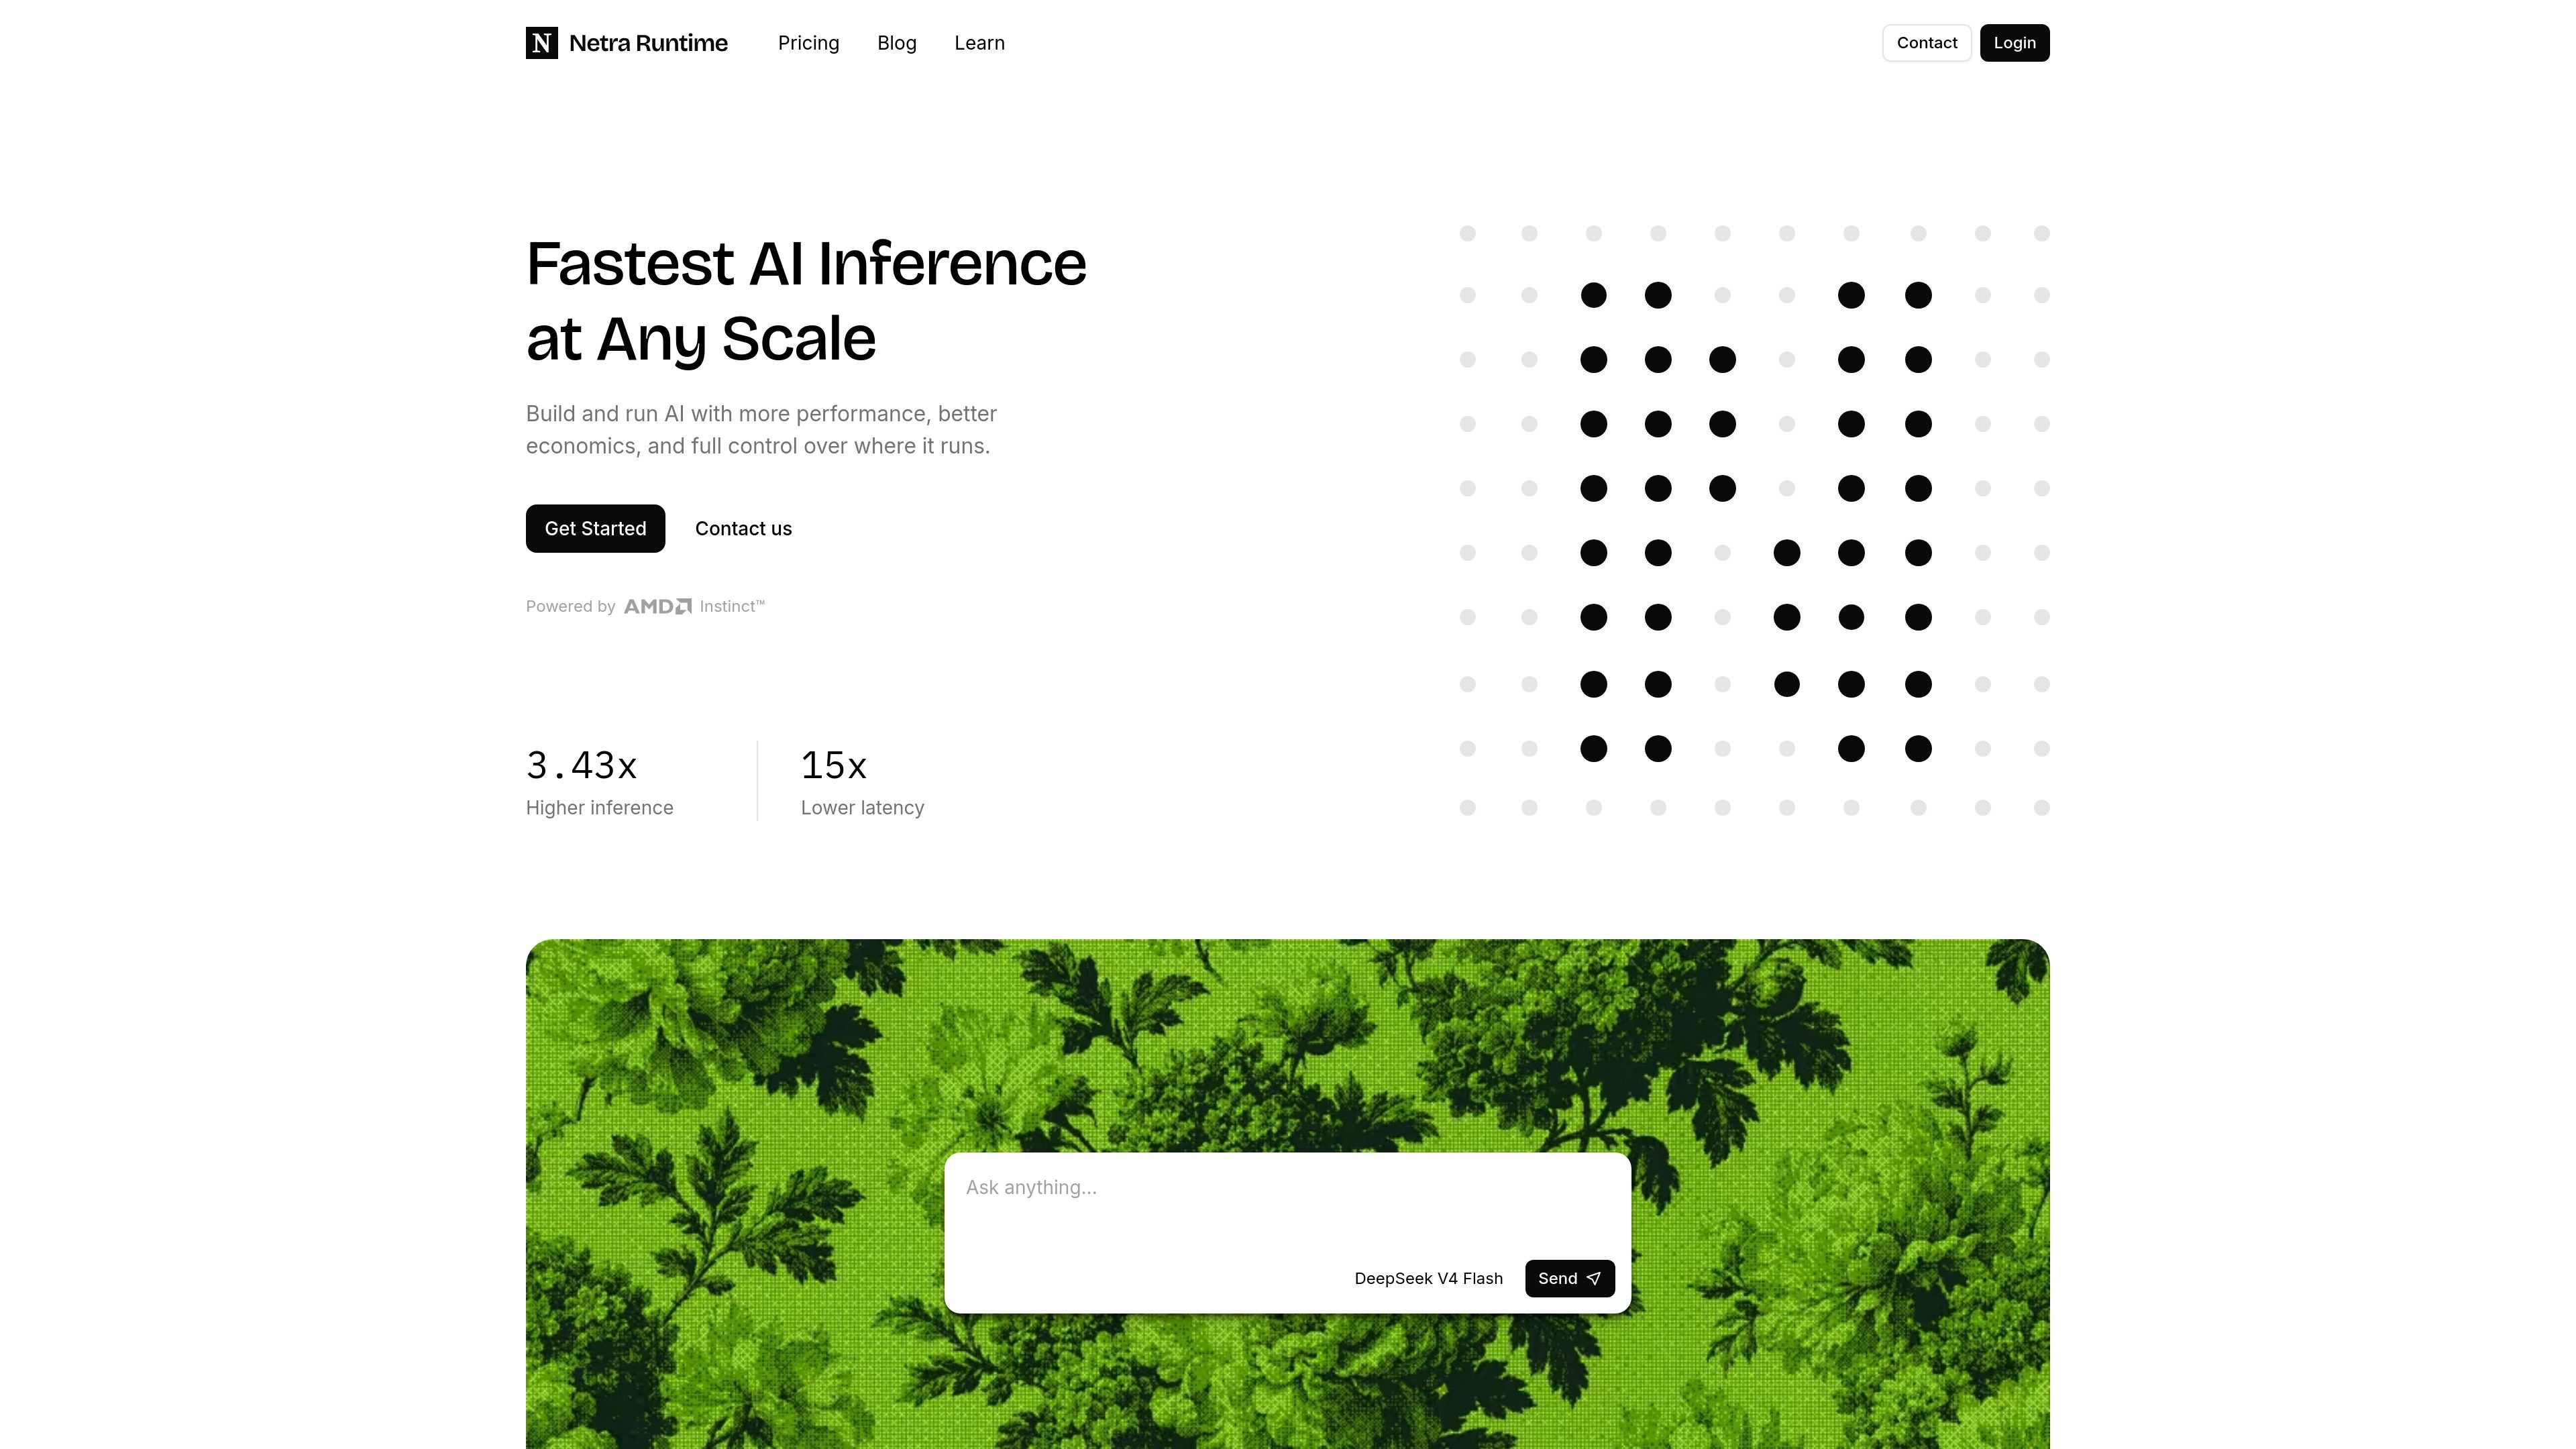
托管式 OpenAI 兼容 API
通过 Netra Cloud 使用托管 GPU 和生产推理 API,无需运营底层 GPU 基础设施。
Netra Runtime 是面向在生产环境运行模型的团队打造的高性能 AI 推理引擎。它位于 AI 应用与 GPU 基础设施之间,通过优化模型执行,旨在实现更低延迟、更高吞吐量以及大规模运行时更稳定的性能。
该产品提供两种部署模式:Netra Cloud 通过 OpenAI 兼容 API 提供托管 GPU 推理,而私有部署则将 Netra Runtime 部署到组织自有的 GPU 环境中。网站还介绍了对开放模型服务、私有微调工作流、监控以及由 Forward Deployed Engineers 支持的企业部署的支持。
通过 Netra Cloud 使用托管 GPU 和生产推理 API,无需运营底层 GPU 基础设施。
将推理运行时直接部署在私有 GPU 基础设施上,使模型和数据保留在组织的环境中。
该平台旨在提升推理吞吐量并降低延迟,帮助现有 GPU 处理更多 AI 工作负载,并可能降低每个 token 的基础设施成本。
随着推理工作负载扩展,跟踪延迟、吞吐量、可靠性和使用情况,为生产环境中的模型服务提供运营可见性。
在托管 GPU 上提供开放模型服务,并在私有数据上运行调优或微调后的模型,同时保持数据集和检查点私有。
公开的 Netra Kernel 仓库提供采用 MIT 许可证的特定目标 AMDGPU 内核、验证工具、运行时桥接组件,以及针对受支持契约的 SGLang 服务集成。
团队可以通过 Netra Cloud 的 OpenAI 兼容 API 调用开放模型,并借助托管 GPU 开始提供模型服务,无需构建自己的 GPU 运维层。
拥有现有 AMD 或 NVIDIA 算力的组织可以将 Netra Runtime 与其基础设施一同部署,在保留对模型和数据控制权的同时提升服务性能。
模型团队可以在私有数据集上微调模型,同时将数据集和检查点保留在受控工作流中,然后在生产环境中提供生成的模型服务。
工程和运营团队可以监控延迟、吞吐量、可靠性和使用情况,从而在需求增长时评估和管理 AI 工作负载。
Netra Runtime 是一款高性能推理引擎,位于 AI 应用与 GPU 基础设施之间。它针对生产环境中的模型服务优化模型执行,重点提升吞吐量、降低延迟并提高 GPU 利用率。
是的。Netra Cloud 通过 OpenAI 兼容 API 提供托管推理,因此团队无需自行运营 GPU 即可使用 Netra 的推理服务。
是的。Netra Runtime 可以部署在组织自有的 GPU 基础设施上,使模型和数据保留在该环境中。企业或私有部署支持包括 Forward Deployed Engineers 提供的协助。
Netra 面向 AMD 和 NVIDIA GPU 基础设施设计。已发布的基准测试包括 AMD Instinct MI350X 和 NVIDIA H200,但具体 GPU 和模型配置是否受支持,应向 Netra 确认。
Netra Cloud 采用预付额度模式。定价页面提供模型输入和输出的使用成本,团队可以在充值前估算支出;付款通过 Doku 处理。
AakarDev AI 帮助团队在一个仪表板中管理 AI provider 访问、项目级设置、日志和分析,支持 BYOK 工作流,并涵盖 OpenAI、Google Gemini、Anthropic、Groq、Mistral AI 和 Perplexity AI。
ByteAsk 是面向 C 和 C++ 的终端优先 AI 编码 agent,可直接编辑仓库,并在展示 diff 前用真实编译器、调试器、sanitizers 和测试验证修改。提供免费版与付费方案。

CreateOS Sandbox 是基于 Firecracker 微型虚拟机的隔离计算环境,用于运行代码和 agent 工作负载,支持私有网络、SDK、CLI 和 MCP 程序化控制。

GitBot 是基于本地浏览器的工作区,可借助 Claude Code、Codex 或 OpenCode 创建可复用的编程机器人,跨仓库文件夹运行代理,并保留持久线程与可配置权限。

hob 是面向编码 agent 的独立工作区,可将 agent 会话、终端、历史记录和后续工作围绕你已在用的工具与提供商有序管理,适合重视本地路由、历史和工作区结构控制的开发者。

Ably Chat 是用于构建自定义实时聊天应用的 chat API 平台,支持房间消息、输入指示、在线状态、表情回应与消息更新,并提供按使用量计费选项。