

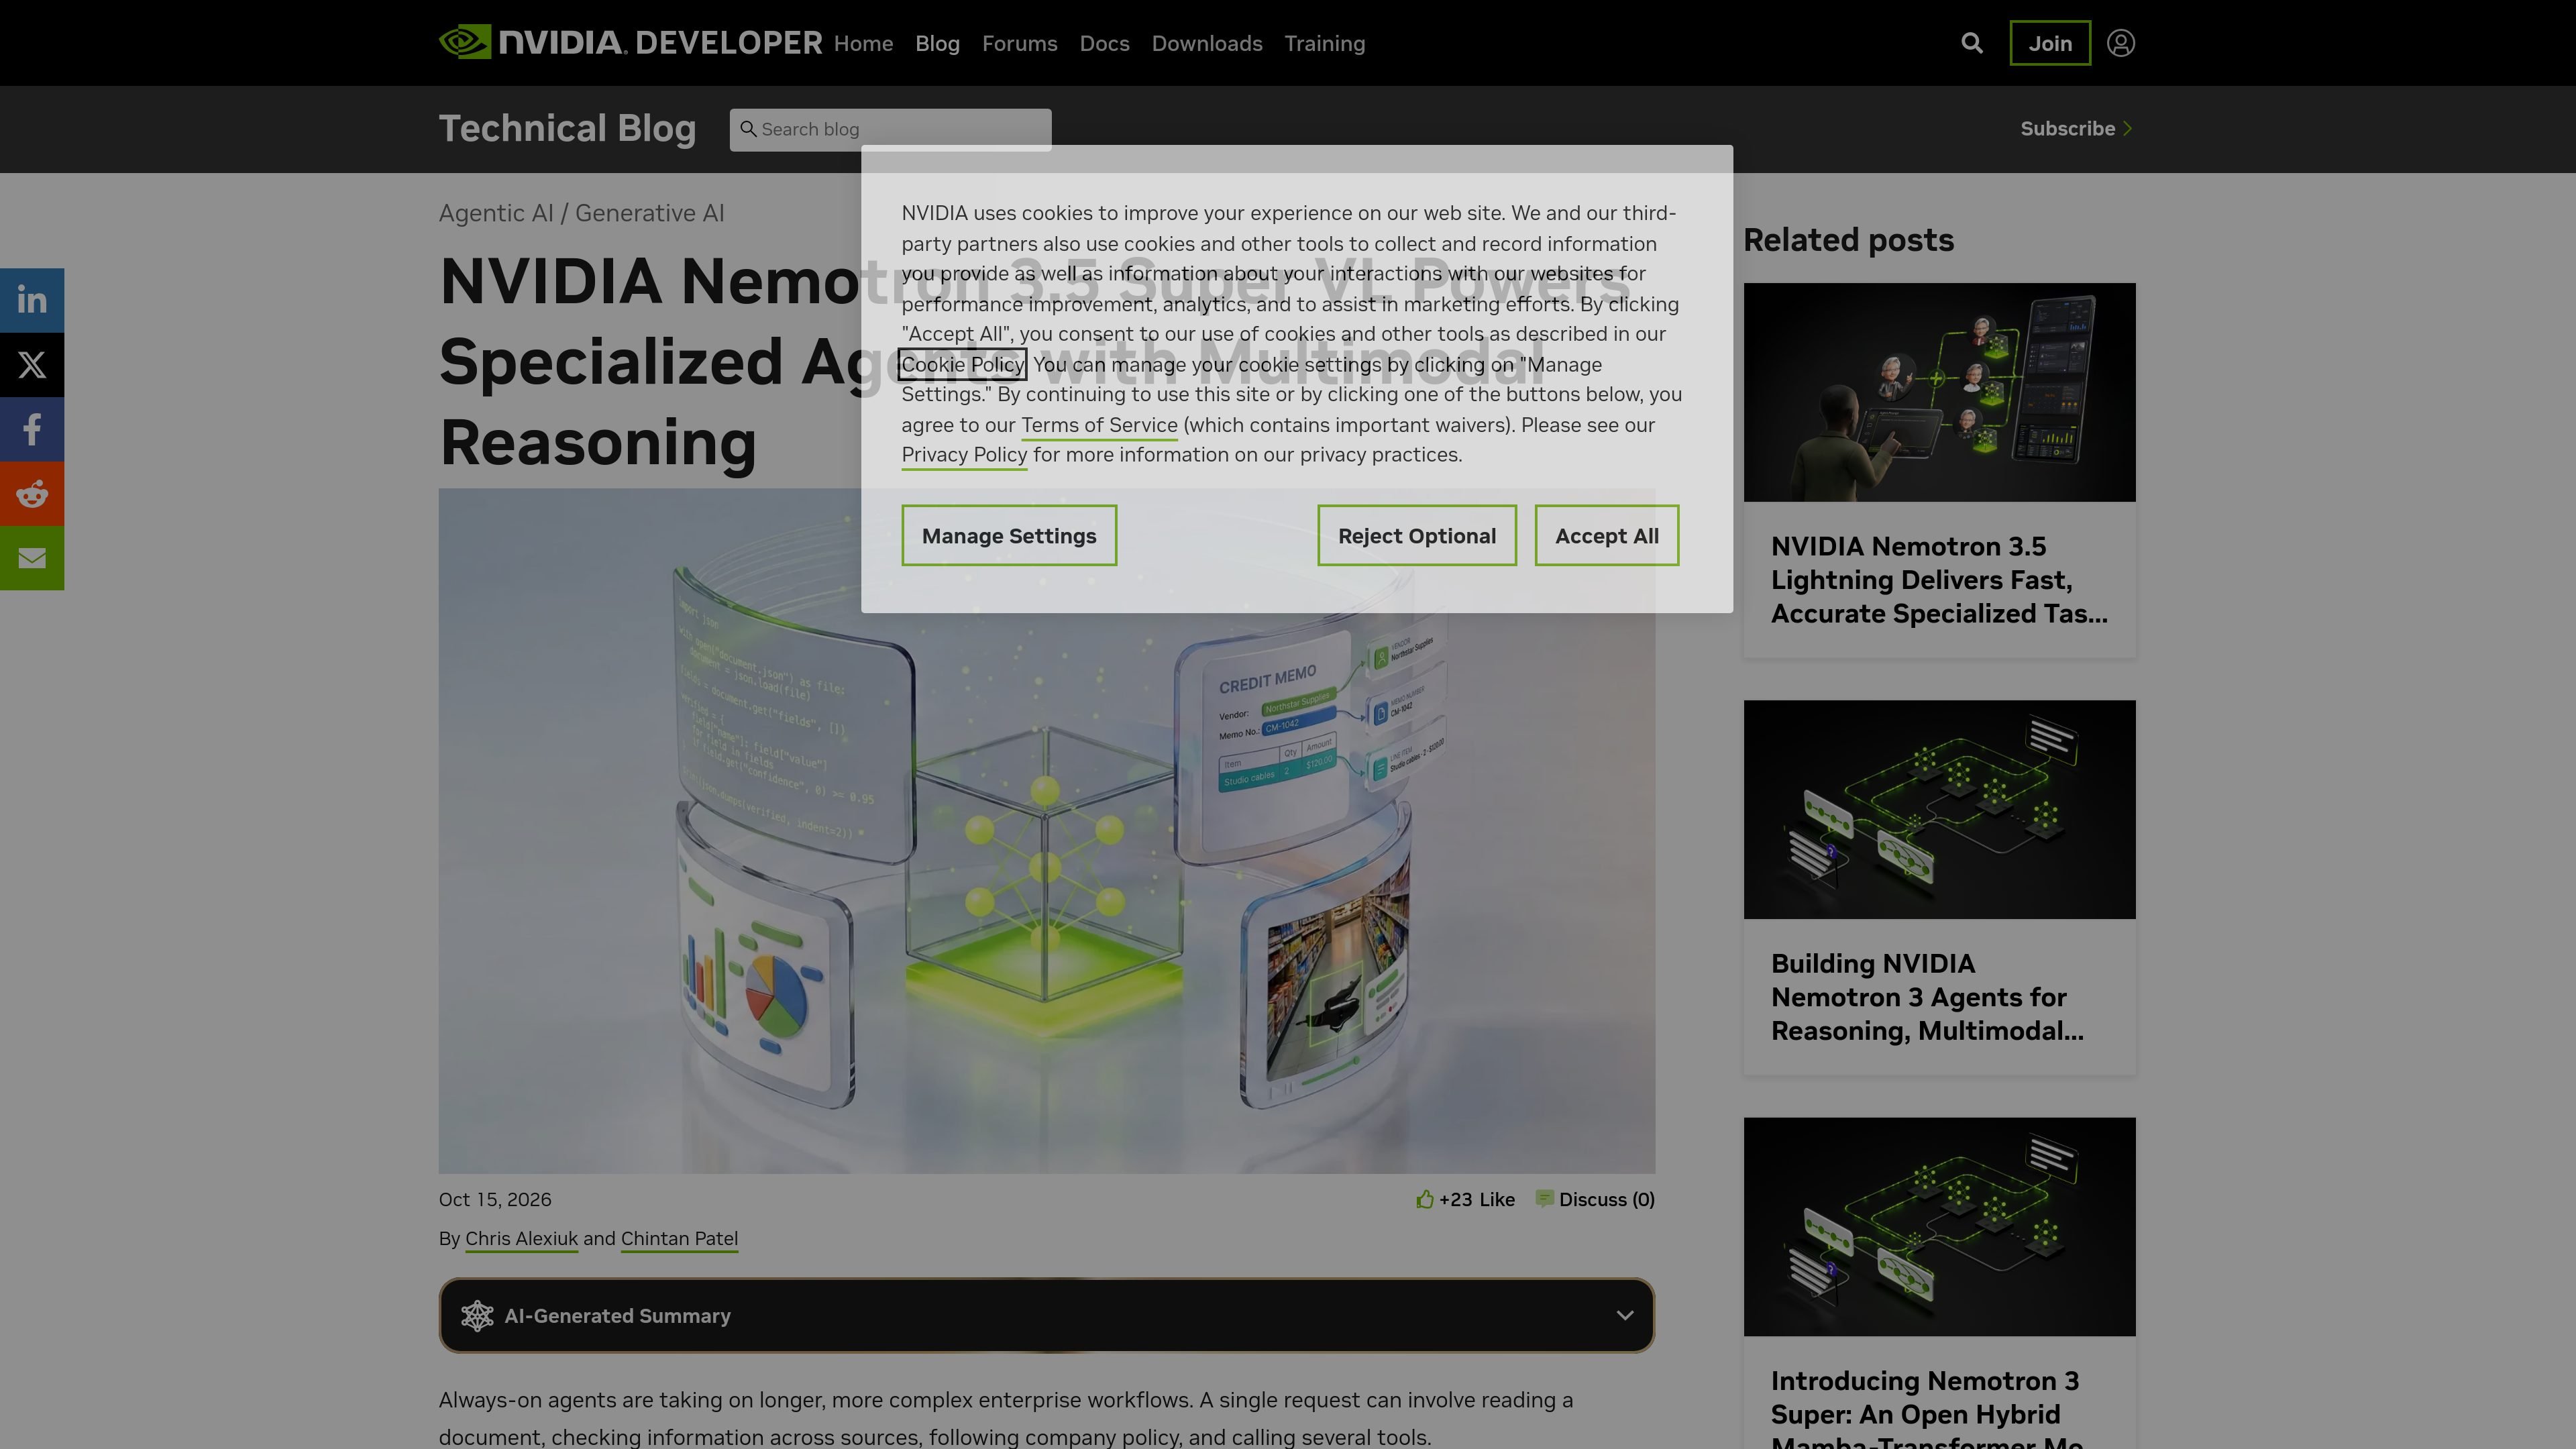
混合容量 MoE 设计
采用 120B 参数的混合专家架构,每个令牌激活 12B 参数,在模型总容量与更具选择性的计算之间取得平衡。
NVIDIA Nemotron 3.5 Super VL 是面向专业 AI 智能体的开放式可定制多模态模型。它专为可能需要推理、工具调用、遵循策略以及解读文本、图像、文档和视频的多步骤企业工作流而设计。
其 120B 参数混合专家架构每个令牌激活 12B 参数。该模型可以作为更广泛 Nemotron 系统中的多模态推理组件,与用于高容量文本任务的小型模型以及用于复杂规划和编排的大型模型协同工作。开发者可以使用 NVIDIA NeMo,基于特定领域的数据、工具和操作规程对其进行调整。
采用 120B 参数的混合专家架构,每个令牌激活 12B 参数,在模型总容量与更具选择性的计算之间取得平衡。
在一个模型中,将推理、指令遵循和工具调用与文本、图像、文档及视频理解相结合。
支持文档工作流,可理解表格、图表和页面布局,同时支持视频搜索、审查和事件分析。
可以使用 NVIDIA NeMo,基于组织的数据、工具接口、操作规程和策略进行后训练。
采用 LiLiCorr 推测解码、结合量化感知蒸馏的 NVFP4 量化、多令牌预测和上下文复用,以提升推理效率。
发布文章称,在 Artificial Analysis Intelligence Index 智能体任务端点上,输出速度超过每秒 600 个令牌;在单个 GPU 上,其吞吐量最高可达到同等规模类别中其他开放模型的 5 倍。结果取决于所述基准测试和部署条件。
在结合推理和工具调用的工作流中测试和验证代码、分析错误并提出修复建议。
跨网站搜索信息,关联多个来源的内容,并在生成结果前验证答案。
读取表格、图表和页面布局,从复杂文档中提取信息并生成摘要或报告。
识别漏洞并对安全威胁进行分级,以便团队确定修复工作的优先级。
从视频中提取信息,用于搜索、内容审查和事件分析。
Nemotron 3.5 Super VL 面向专业的多步骤智能体工作流,这些工作流结合了推理、工具调用以及对文本、图像、文档或视频的理解。示例包括编码、网络研究、文档智能、网络安全和视频分析。
该模型可以使用 NVIDIA NeMo,利用组织数据、工具、策略和工作流进行后训练。来源还将监督微调、低秩适配和强化学习列为定制方法,并在 Hugging Face 上发布开放数据集。
该模型将推理、指令遵循、工具调用和多模态理解结合在一个模型中,因此工作流可以处理文本和视觉输入,无需针对这些能力分别使用文本模型和视觉语言模型。
来源介绍了通过包括 LiLiCorr 推测解码、结合量化感知蒸馏的 NVFP4 量化、多令牌预测和上下文复用在内的技术进行部署优化。来源建议开发者使用 NVIDIA NIM 进行优化部署,但现有证据未说明完整的部署配置或支持的平台矩阵。
AakarDev AI 帮助团队在一个仪表板中管理 AI provider 访问、项目级设置、日志和分析,支持 BYOK 工作流,并涵盖 OpenAI、Google Gemini、Anthropic、Groq、Mistral AI 和 Perplexity AI。

Benchspan 是一款 AI agent 安全平台,可发现 agent、实时阻止提示注入和数据外泄,并支持上线前红队测试,适用于生产环境中的 agent 团队,提供 Python 和 TypeScript SDK。

CreateOS Sandbox 是基于 Firecracker 微型虚拟机的隔离计算环境,用于运行代码和 agent 工作负载,支持私有网络、SDK、CLI 和 MCP 程序化控制。

GitBot 是基于本地浏览器的工作区,可借助 Claude Code、Codex 或 OpenCode 创建可复用的编程机器人,跨仓库文件夹运行代理,并保留持久线程与可配置权限。

Codex Plugins 将可复用技能、应用集成和 MCP 服务器打包为工作流,可在 Codex 应用中安装或通过 Codex CLI 使用,帮助扩展连接服务任务、复用指令和团队共享流程。

Grok 4.7 是 xAI 推出的软件开发与知识工作模型,支持长时间编码任务和专业分析,可通过 Grok Build、Cursor、Grok API 等平台使用,输入每百万 token 起价 2 美元,输出每百万 token 起价 6 美元。