

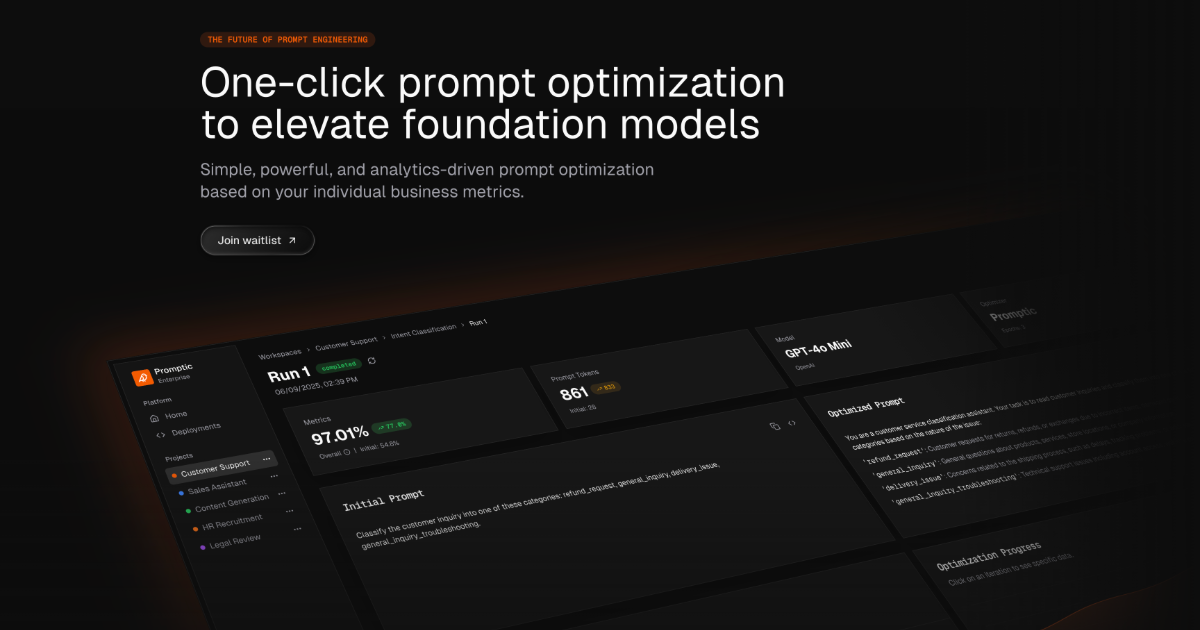
基于数据集的基准评测
上传真实输入和预期输出,在多次运行中保持数据集不变,并在相同任务上为每个候选方案评分。
Promptic 是面向需要评估和改进 LLM 提示词、模型与智能体工作流的团队的 GenAI 优化平台。它使用用户的真实输入和预期输出作为固定评测数据集,然后根据质量、成本和延迟等选定 KPI 对候选方案进行基准评测。
该平台将原生支持 OpenTelemetry 的追踪与自动优化相结合。团队可以查看模型和工作流的行为,找出候选方案成功或失败的环节,比较各种取舍,并发布符合既定优先级的配置。网站所述的支持优化领域包括提示词调优、模型选择、智能体架构、信息提取和工具使用。
上传真实输入和预期输出,在多次运行中保持数据集不变,并在相同任务上为每个候选方案评分。
设定质量、成本和延迟目标,然后使用与应用相关的指标比较候选配置。
根据所提供的数据和约束,自动调优提示词、模型、智能体架构、提取工作流和工具选择。
通过 OpenTelemetry 捕获 LLM 调用、工具调用和工作流步骤,包括 span 级别的令牌数、成本和延迟信息。
检查失败的追踪记录,并在实施变更前比较替代方案,同时记录结果和评测证据以便验证。
定价页面列出了 Team、Business 和 Enterprise 方案中的 API/SDK 访问权限,使团队能够将 Promptic 纳入开发和生产工作流。
在代表性数据集上比较不同提示词版本或基础模型,然后选择达到团队质量目标且不会忽视成本和延迟的选项。
针对相同案例评估基于路由器、工具优先或单智能体的设计,并在更改实现前检查失败的追踪记录。
通过针对预期结果测试候选配置,为发票字段等结构化输出调优提取工作流。
衡量工具选择行为,调查错误或重复的工具调用,从而改进智能体选择和使用工具的方式。
将追踪数据和记录的评测证据作为开发工作流的一部分;适用的付费方案提供 API/SDK 访问权限,面向较大型组织还提供企业部署选项。
Promptic 从真实输入和预期输出组成的固定数据集开始。用户选择质量、成本和延迟等 KPI,然后在相同数据上对候选方案进行基准评测,再查看结果并发布选定的配置。
Promptic 可通过 OpenTelemetry 捕获 LLM 调用、工具调用和工作流步骤。追踪中包含所记录 span 的令牌数、成本、延迟、模型和提供商等信息。
该平台可根据用户数据和 KPI 优化提示词、模型选择、智能体架构、信息提取工作流和工具选择。具体优化范围取决于使用场景。
定价页面列出了 Free、Team、Business 和 Enterprise 方案。Team 和 Business 方案增加了优化、评测、追踪和 API/SDK 访问等功能,而 Enterprise 支持定制条款以及 Private Cloud 或 BYOC 等部署选项。
可以。Promptic 支持比较候选模型,并支持通过用户提供的模型密钥访问模型;在适用的付费方案中,也可选择使用托管模型,相关费用另行计费。
AakarDev AI 帮助团队在一个仪表板中管理 AI provider 访问、项目级设置、日志和分析,支持 BYOK 工作流,并涵盖 OpenAI、Google Gemini、Anthropic、Groq、Mistral AI 和 Perplexity AI。
ByteAsk 是面向 C 和 C++ 的终端优先 AI 编码 agent,可直接编辑仓库,并在展示 diff 前用真实编译器、调试器、sanitizers 和测试验证修改。提供免费版与付费方案。

CreateOS Sandbox 是基于 Firecracker 微型虚拟机的隔离计算环境,用于运行代码和 agent 工作负载,支持私有网络、SDK、CLI 和 MCP 程序化控制。

GitBot 是基于本地浏览器的工作区,可借助 Claude Code、Codex 或 OpenCode 创建可复用的编程机器人,跨仓库文件夹运行代理,并保留持久线程与可配置权限。

hob 是面向编码 agent 的独立工作区,可将 agent 会话、终端、历史记录和后续工作围绕你已在用的工具与提供商有序管理,适合重视本地路由、历史和工作区结构控制的开发者。

Ably Chat 是用于构建自定义实时聊天应用的 chat API 平台,支持房间消息、输入指示、在线状态、表情回应与消息更新,并提供按使用量计费选项。