

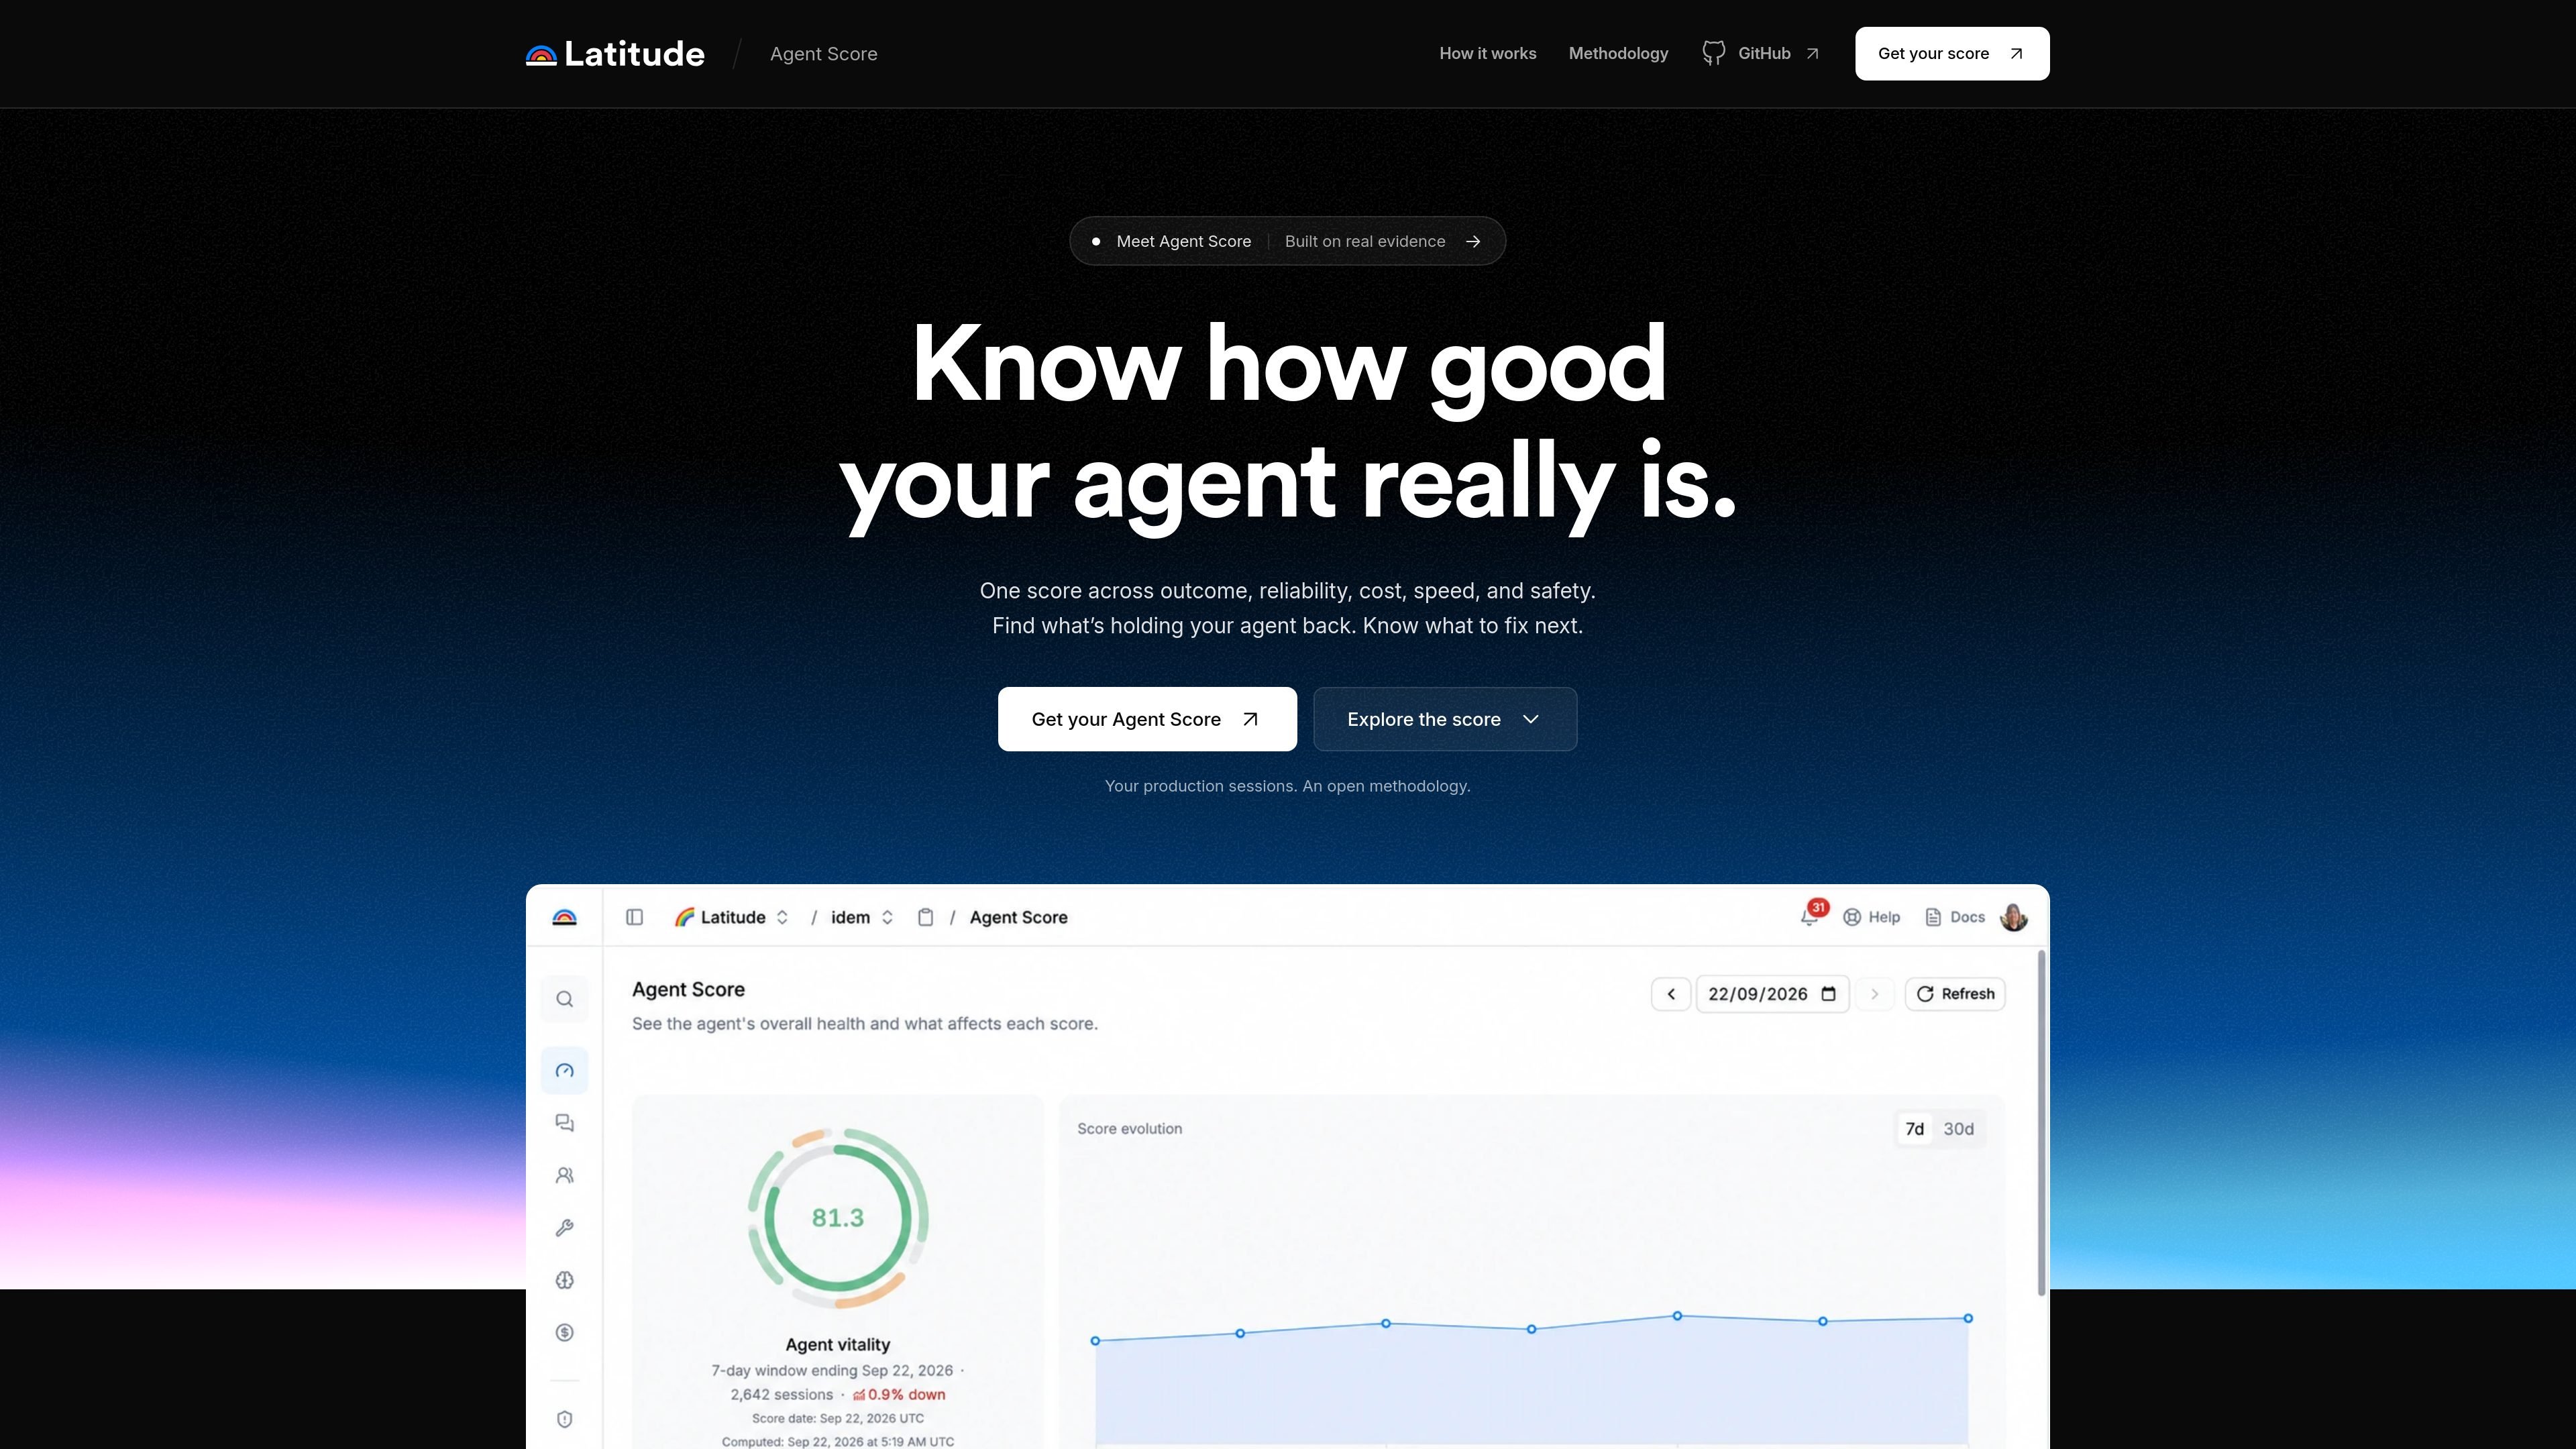
五面向 Agent Score
將成果、可靠性、成本、速度與安全性整合在單一檢視中,讓團隊能評估各項取捨,而不是只最佳化單一指標。
Latitude Agent Score 是一項以正式環境證據評估 AI 代理的工具。它會將正式環境中經過追蹤的工作階段轉換為涵蓋成果、可靠性、成本、速度與安全性的分數,協助團隊了解代理是否完成任務、在操作上失敗、使用了可避免的資源、造成延遲,或導致已確認的傷害。
這項分數的設計是作為調查起點,而非獨立的基準測試。團隊可以檢視結果背後的工作階段,找出反覆出現的失敗模式,將其轉換為評估,並在修正上線後比較行為。Latitude 可透過 OpenTelemetry 或現有的追蹤資料接收追蹤資訊,而評分是否啟用則取決於流量、涵蓋範圍與信賴度要求。
將成果、可靠性、成本、速度與安全性整合在單一檢視中,讓團隊能評估各項取捨,而不是只最佳化單一指標。
以正式環境工作階段作為證據,回報 95% 信賴區間;證據不足時則不提供分數。
顯示分數變化與失敗背後的工作階段,讓團隊能從彙總結果深入了解底層的正式環境行為。
協助團隊找出反覆出現的問題,將失敗模式轉為評估,並在後續正式環境工作階段中監控相同的行為。
透過 OpenTelemetry 或現有的追蹤資料接收正式環境追蹤資料,並可透過 Latitude 遙測資料擷取代理訊息、成本、工具呼叫與錯誤。
透過 MCP 將證據連結至以編輯器為基礎的工作流程,讓程式碼代理接收問題脈絡,並協助在上線後驗證變更。
結合五個面向,了解版本發布是否改善了實際任務完成度,同時未引發新的可靠性、成本、速度或安全性問題。
從分數下滑或反覆出現的訊號,追查至受影響的正式環境工作階段,接著找出共同的失敗行為,而不是只檢視個別記錄。
將已驗證的正式環境失敗轉為評估,並在後續工作階段中持續追蹤,以確認修正是否仍然有效。
透過 MCP 將相關問題脈絡、範例追蹤資料與工作區連結提供給程式碼代理,接著在修正部署後驗證代理的行為。
Agent Score 會從五個面向評估正式環境工作階段:成果、可靠性、成本、速度與安全性。其目的在於顯示哪些因素正在影響代理的效能,以及下一步應調查哪項有證據支持的改善方向。
透過 OpenTelemetry 連接正式環境工作階段,或匯入現有的追蹤資料。Latitude 會處理傳入的證據,並檢查是否符合取得分數的資格要求。
只有在五個面向都通過所需的流量、涵蓋範圍與信賴度門檻後,才會顯示分數。Latitude 表示至少需要 1,000 個符合資格的工作階段,且證據必須涵蓋符合條件的完整週期視窗:7、14、21 或 28 天。
每個分數都包含 95% 信賴區間。如果證據不足,Latitude 目前不會顯示分數。
Latitude 提供免費的 Starter 方案與付費的 Pro 方案,Enterprise 則提供自訂額度、保留期限、部署、角色與支援選項。價格與限制依方案而異。

ByteAsk 是專為 C 與 C++ 打造的終端機優先 AI coding agent,先編輯儲存庫再用真實編譯器、除錯器、sanitizer 與測試驗證變更,並提供免費方案與付費方案。

Manta AI 是一款自動化網頁應用測試工具,從 URL 即可開始探索、建立行為地圖,並以自然語言產生測試與回歸檢查,無需撰寫腳本或維護 selector。

EAS Observe 是適用於 Expo 與 React Native 應用程式的正式環境效能監控工具,可在 Expo 儀表板查看啟動指標、工作階段時間軸、版本標記與錯誤。

Traccia 是一個代理可觀測性與治理平台,提供 OpenTelemetry 原生追蹤、政策強制、提示評估與合規證據,支援 LangChain、CrewAI、OpenAI Agents SDK、AutoGen 與 LlamaIndex。
Hoplite 是一個雲端程式碼代理平台,讓團隊能在隔離沙箱中執行軟體任務,並保留儲存庫內容與匯入的本機設定;提供 Pro、Scale 與 Enterprise 方案。

CmdRound 是專為招募人員設計的工程評測工具,透過真實編碼任務評估候選人使用 Claude Code 的方式,並提供結構化評分卡與決策、代理互動及測試結果的時間順序重播。