
決策評分
此模型專為評分決策而打造,並回傳軟體可在後續邏輯中使用的結構化輸出。
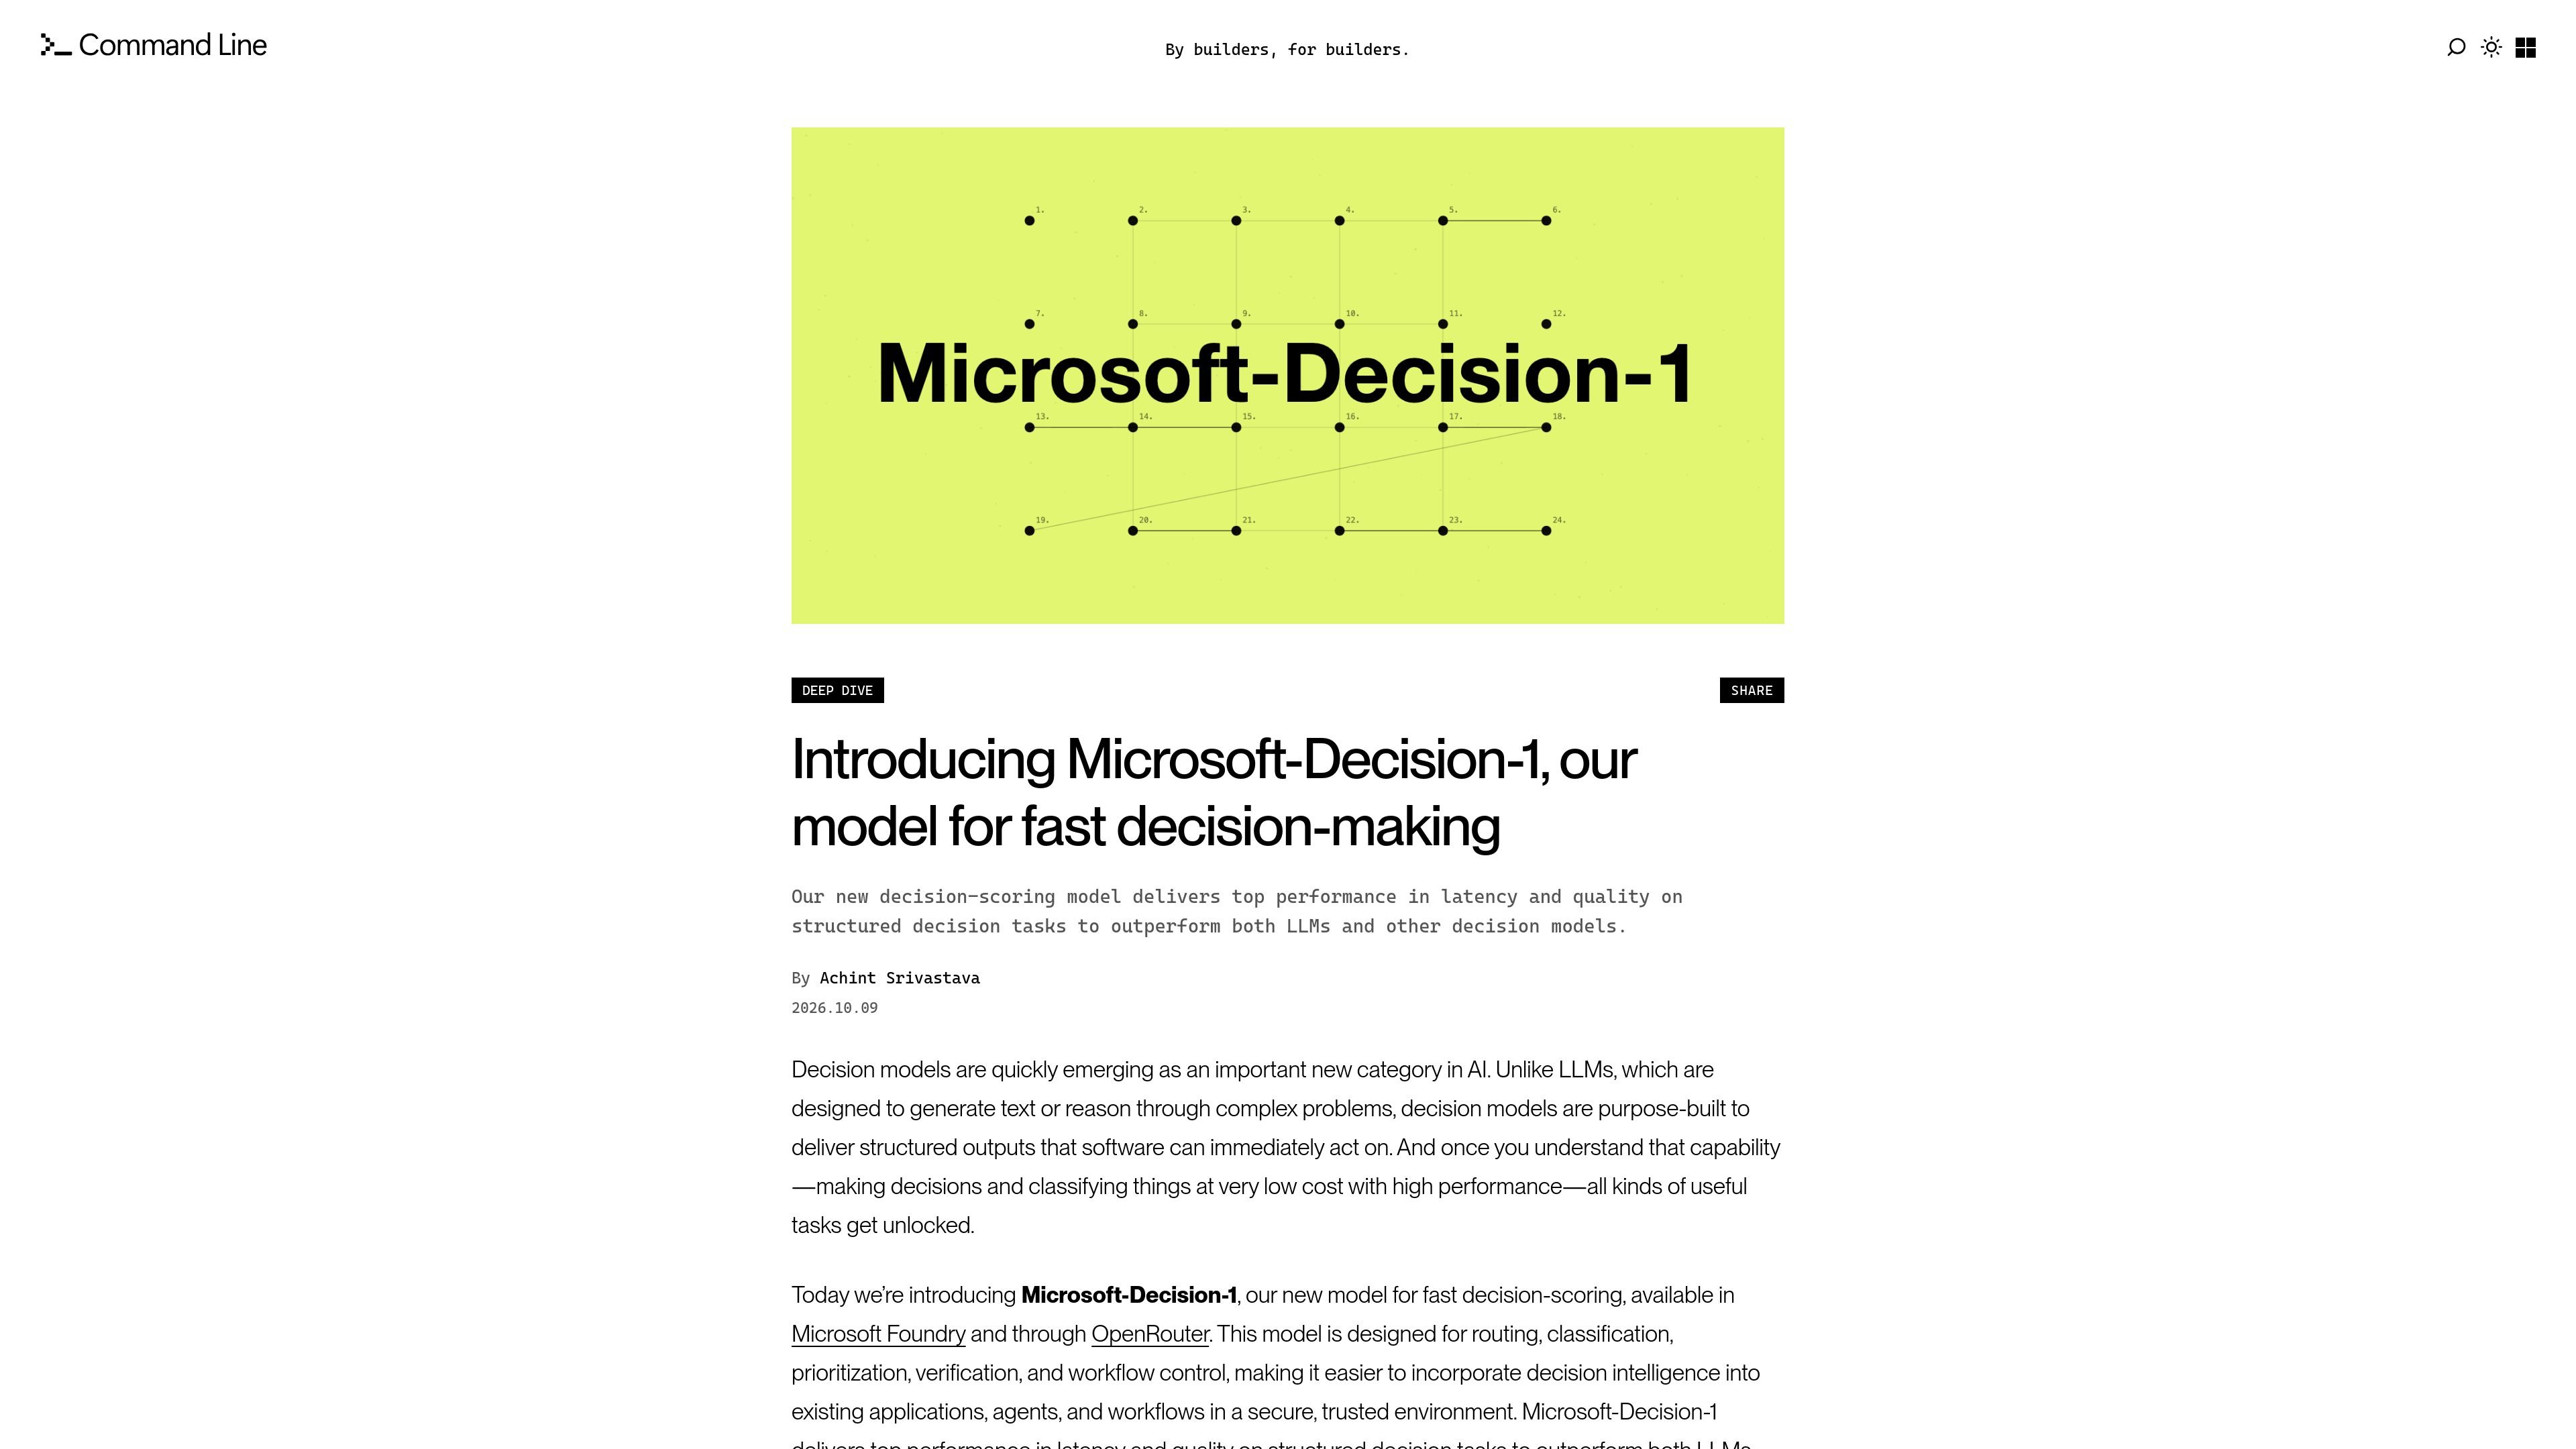
Microsoft-Decision-1 是 Microsoft 推出的決策評分模型,用於結構化決策任務。不同於主要用來產生文字或處理複雜問題的語言模型,此模型旨在產生軟體可直接採取行動的結構化輸出。
此模型面向路由、分類、優先排序、驗證與工作流程控制。Microsoft 表示可透過 Microsoft Foundry 和 OpenRouter 使用,並公布了著重於準確度、延遲與校準的基準測試結果。現有來源未提供詳細設定說明、輸出格式、定價或部署限制。
此模型專為評分決策而打造,並回傳軟體可在後續邏輯中使用的結構化輸出。
Microsoft 將此模型定位為可將輸入分入不同類別,支援自動化分類工作流程。
此模型專為低延遲決策任務設計;公告指出,在其基準測試中,測得的效能比所比較的模型更快。
此模型可支援路由和工作流程控制決策,協助軟體系統選擇路徑或採取行動。
公告列出的使用案例包括優先排序與驗證,讓應用程式能在自動化流程中排列項目或檢查決策。
Microsoft-Decision-1 可透過 Microsoft Foundry 和 OpenRouter 提供,這些是文件所述的模型使用管道。
使用模型的結構化決策,將傳入的請求、記錄或事件導向適當的軟體路徑或處理程式。
在應用程式需要將輸入指派至預先定義的類別,並在之後採取行動時,套用模型產生的分類結果。
排列或排序項目,讓系統能優先處理優先級較高的案例。
加入驗證步驟,在分類或其他結構化決策進入自動化工作流程前進行檢查。
在應用程式或代理程式中,將決策輸出用作分支、閘控或其他工作流程邏輯的控制訊號。
根據產品公告,Microsoft-Decision-1 可透過 Microsoft Foundry 和 OpenRouter 使用。
此模型 предназначено 用於結構化決策任務,包括路由、分類、優先排序、驗證與工作流程控制。來源未提供設定說明或詳細的輸出結構。
Microsoft 將其描述為決策評分模型,可產生軟體能夠採取行動的結構化輸出,而不是主要用於產生文字的通用模型。
公告提供了 36 項基準測試的比較結果,涵蓋近 150,000 個與訓練資料隔離的問題。公告指出其在該比較中具有最快的測量延遲,但現有來源未提供完整的方法論或部署規格。

Grok 4.7 是 xAI 為軟體開發與知識工作打造的 AI 模型,支援長時間程式設計與專業分析,可透過 Grok Build、Cursor、Grok API 等平台使用;輸入每百萬 token $2 起,輸出 $6 起。
AakarDev AI 讓團隊透過單一儀表板管理 AI 供應商權限、專案設定、日誌與分析,支援 BYOK 工作流程,並可連接 OpenAI、Google Gemini、Anthropic、Groq、Mistral AI、Perplexity AI。

BookAI允許您透過簡單提供書名和作者與您的書籍進行AI聊天。

Skills Janitor 是一套託管於 GitHub 的斜線指令,用於稽核、追蹤與管理 Claude Code 和 OpenAI Codex skills;可找出重複項、失效連結與未使用 skills,並以獨立指令清理整理。

FeelFish 是一款支援 AI 輔助小說寫作的 PC 用戶端,協助小說創作者規劃角色與場景、撰寫與修訂長篇內容,並管理故事脈絡。提供免費方案與付費方案,支援多家大型模型供應商。

Benchspan 是一個 AI agent 安全平台,可即時發現 agents、阻擋 prompt injection 與資料外洩,並支援上線前紅隊測試,適合在 production 環境運行 agents 的團隊,並提供 Python 與 TypeScript SDKs。