

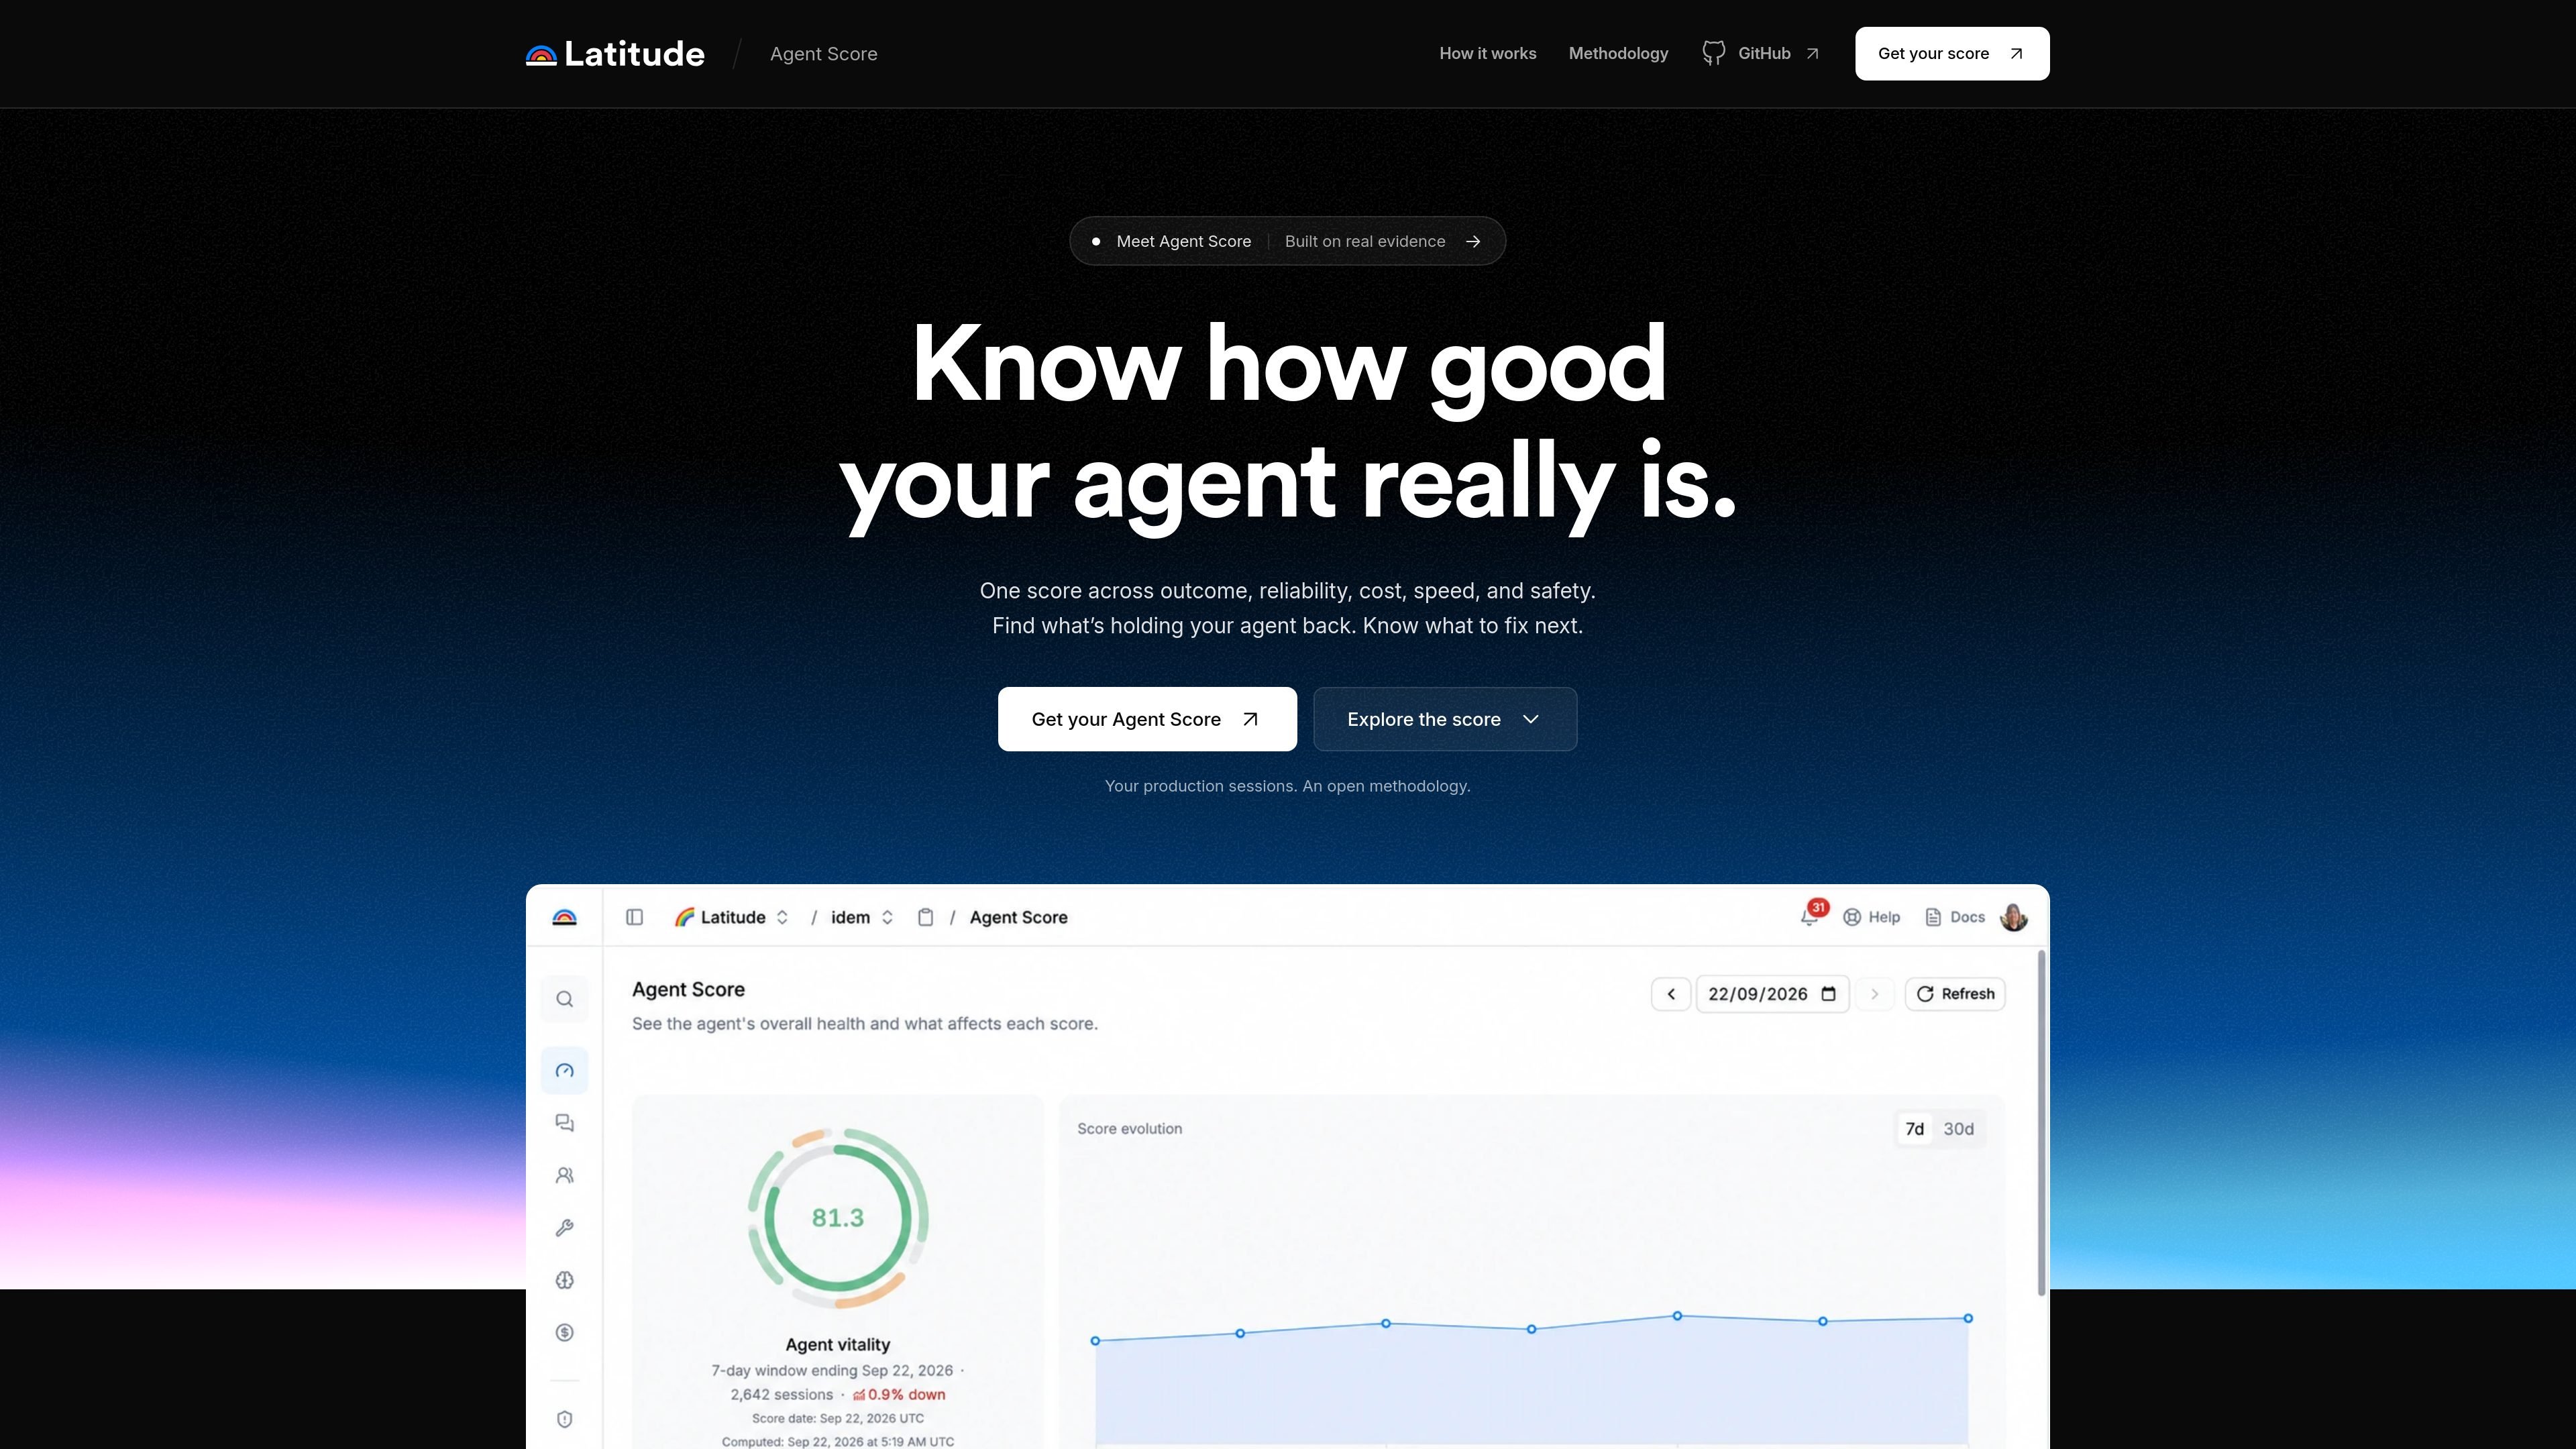
五维 Agent Score
将结果、可靠性、成本、速度和安全性整合到一个视图中,帮助团队评估各种权衡,而不是只优化单一指标。
Latitude Agent Score 是一款基于生产环境证据评估 AI agent 的工具。它将经过追踪的生产环境会话转化为涵盖结果、可靠性、成本、速度和安全性的评分,帮助团队了解 agent 是否完成任务、是否出现运行故障、是否使用了可避免的资源、是否引入延迟或造成已确认的损害。
该评分旨在作为调查的起点,而不是独立的基准。团队可以检查评分结果背后的会话,识别重复出现的故障模式,将其转化为评测,并在修复发布后比较行为。Latitude 通过 OpenTelemetry 或已有的追踪数据接收追踪信息,并根据流量、覆盖率和置信度要求决定是否提供评分。
将结果、可靠性、成本、速度和安全性整合到一个视图中,帮助团队评估各种权衡,而不是只优化单一指标。
以生产环境会话作为证据,并报告 95% 置信区间;当证据不足时不提供评分。
展示评分变化和故障背后的会话,让团队能够从汇总结果深入了解底层生产环境行为。
帮助团队识别重复出现的问题,将故障模式转化为评测,并在后续生产环境会话中监测相同行为。
通过 OpenTelemetry 或已有的追踪数据接收生产环境追踪信息,并可通过 Latitude telemetry 采集 agent 消息、成本、工具调用和错误。
通过 MCP 将证据连接到基于编辑器的工作流,使编码 agent 能够获取问题上下文,并帮助验证发布后的变更。
结合五个维度,了解某次发布是否提升了真实任务完成情况,同时没有引入新的可靠性、成本、速度或安全性问题。
从评分下降或重复出现的信号追溯到受影响的生产环境会话,然后识别共同的故障行为,而不是逐一查看孤立日志。
将经过验证的生产环境故障转化为评测,并在后续会话中持续跟踪,以检查修复是否仍然有效。
通过 MCP 向编码 agent 提供相关问题上下文、示例追踪数据和工作区链接,然后在修复部署后验证 agent 的行为。
Agent Score 从五个维度评估生产环境会话:结果、可靠性、成本、速度和安全性。它旨在展示哪些因素正在影响 agent 的表现,以及下一步应调查哪项有证据支持的改进方向。
通过 OpenTelemetry 连接生产环境会话,或导入已有的追踪数据。Latitude 会处理传入的证据,并检查是否满足获得评分的资格要求。
只有当五个维度都通过规定的流量、覆盖率和置信度门槛后,才会显示评分。Latitude 表示至少需要 1,000 个符合条件的会话,并且证据必须覆盖符合要求的完整周时间窗口:7 天、14 天、21 天或 28 天。
每项评分都包含 95% 置信区间。如果证据不足,Latitude 暂时不会显示评分。
Latitude 提供免费的 Starter 计划和付费的 Pro 计划,并为自定义额度、数据保留、部署、角色和支持提供 Enterprise 选项。不同计划的价格和限制有所不同。

ByteAsk 是面向 C 和 C++ 的终端优先 AI 编码 agent,可直接编辑仓库,并在展示 diff 前用真实编译器、调试器、sanitizers 和测试验证修改。提供免费版与付费方案。

Manta AI 是面向团队的自治式网页应用测试工具,可从 URL 自动探索应用、映射行为、捕捉回归,并用自然语言生成测试,无需脚本或维护选择器。

EAS Observe 是面向 Expo 和 React Native 应用的生产环境性能监控工具,可在 Expo 控制台中查看启动指标、会话时间线、版本标记和错误信息。

Traccia 是面向 AI 工作流的智能体可观测与治理平台,提供 OpenTelemetry 原生追踪、策略执行、提示评估和合规证据,支持 LangChain、CrewAI、OpenAI Agents SDK、AutoGen 和 LlamaIndex。
Hoplite 是面向团队的云端编码代理平台,可在隔离沙盒中运行软件任务,并保留仓库上下文与导入的本地配置,提供 Pro、Scale 和 Enterprise 方案。

CmdRound 是面向招聘人员的工程评估工具,用于评估候选人使用 Claude Code 完成真实编码任务的能力,并通过结构化评分卡与时间线回放呈现决策、智能体交互及测试结果。