
編集可能なエージェントハーネスのコンポーネント
フレームワークは、周辺のエージェントシステムを編集可能なコンポーネントとして扱います。対象には、システムプロンプト、ガードレール、メモリ、ツールのガイダンス、サブエージェント、スキル、スクリプト、プラグインが含まれます。これらのコンポーネントは、コンテキストの構築、ツール、委任、ツールループ内の動作を制御します。

Harness²は、固定AIモデルのプロンプト、ツール、メモリなどを改善するオープンソースフレームワーク。JobBench、LAB、WorkBuddy-Benchで再帰的な改善ワークフローを実行できます。
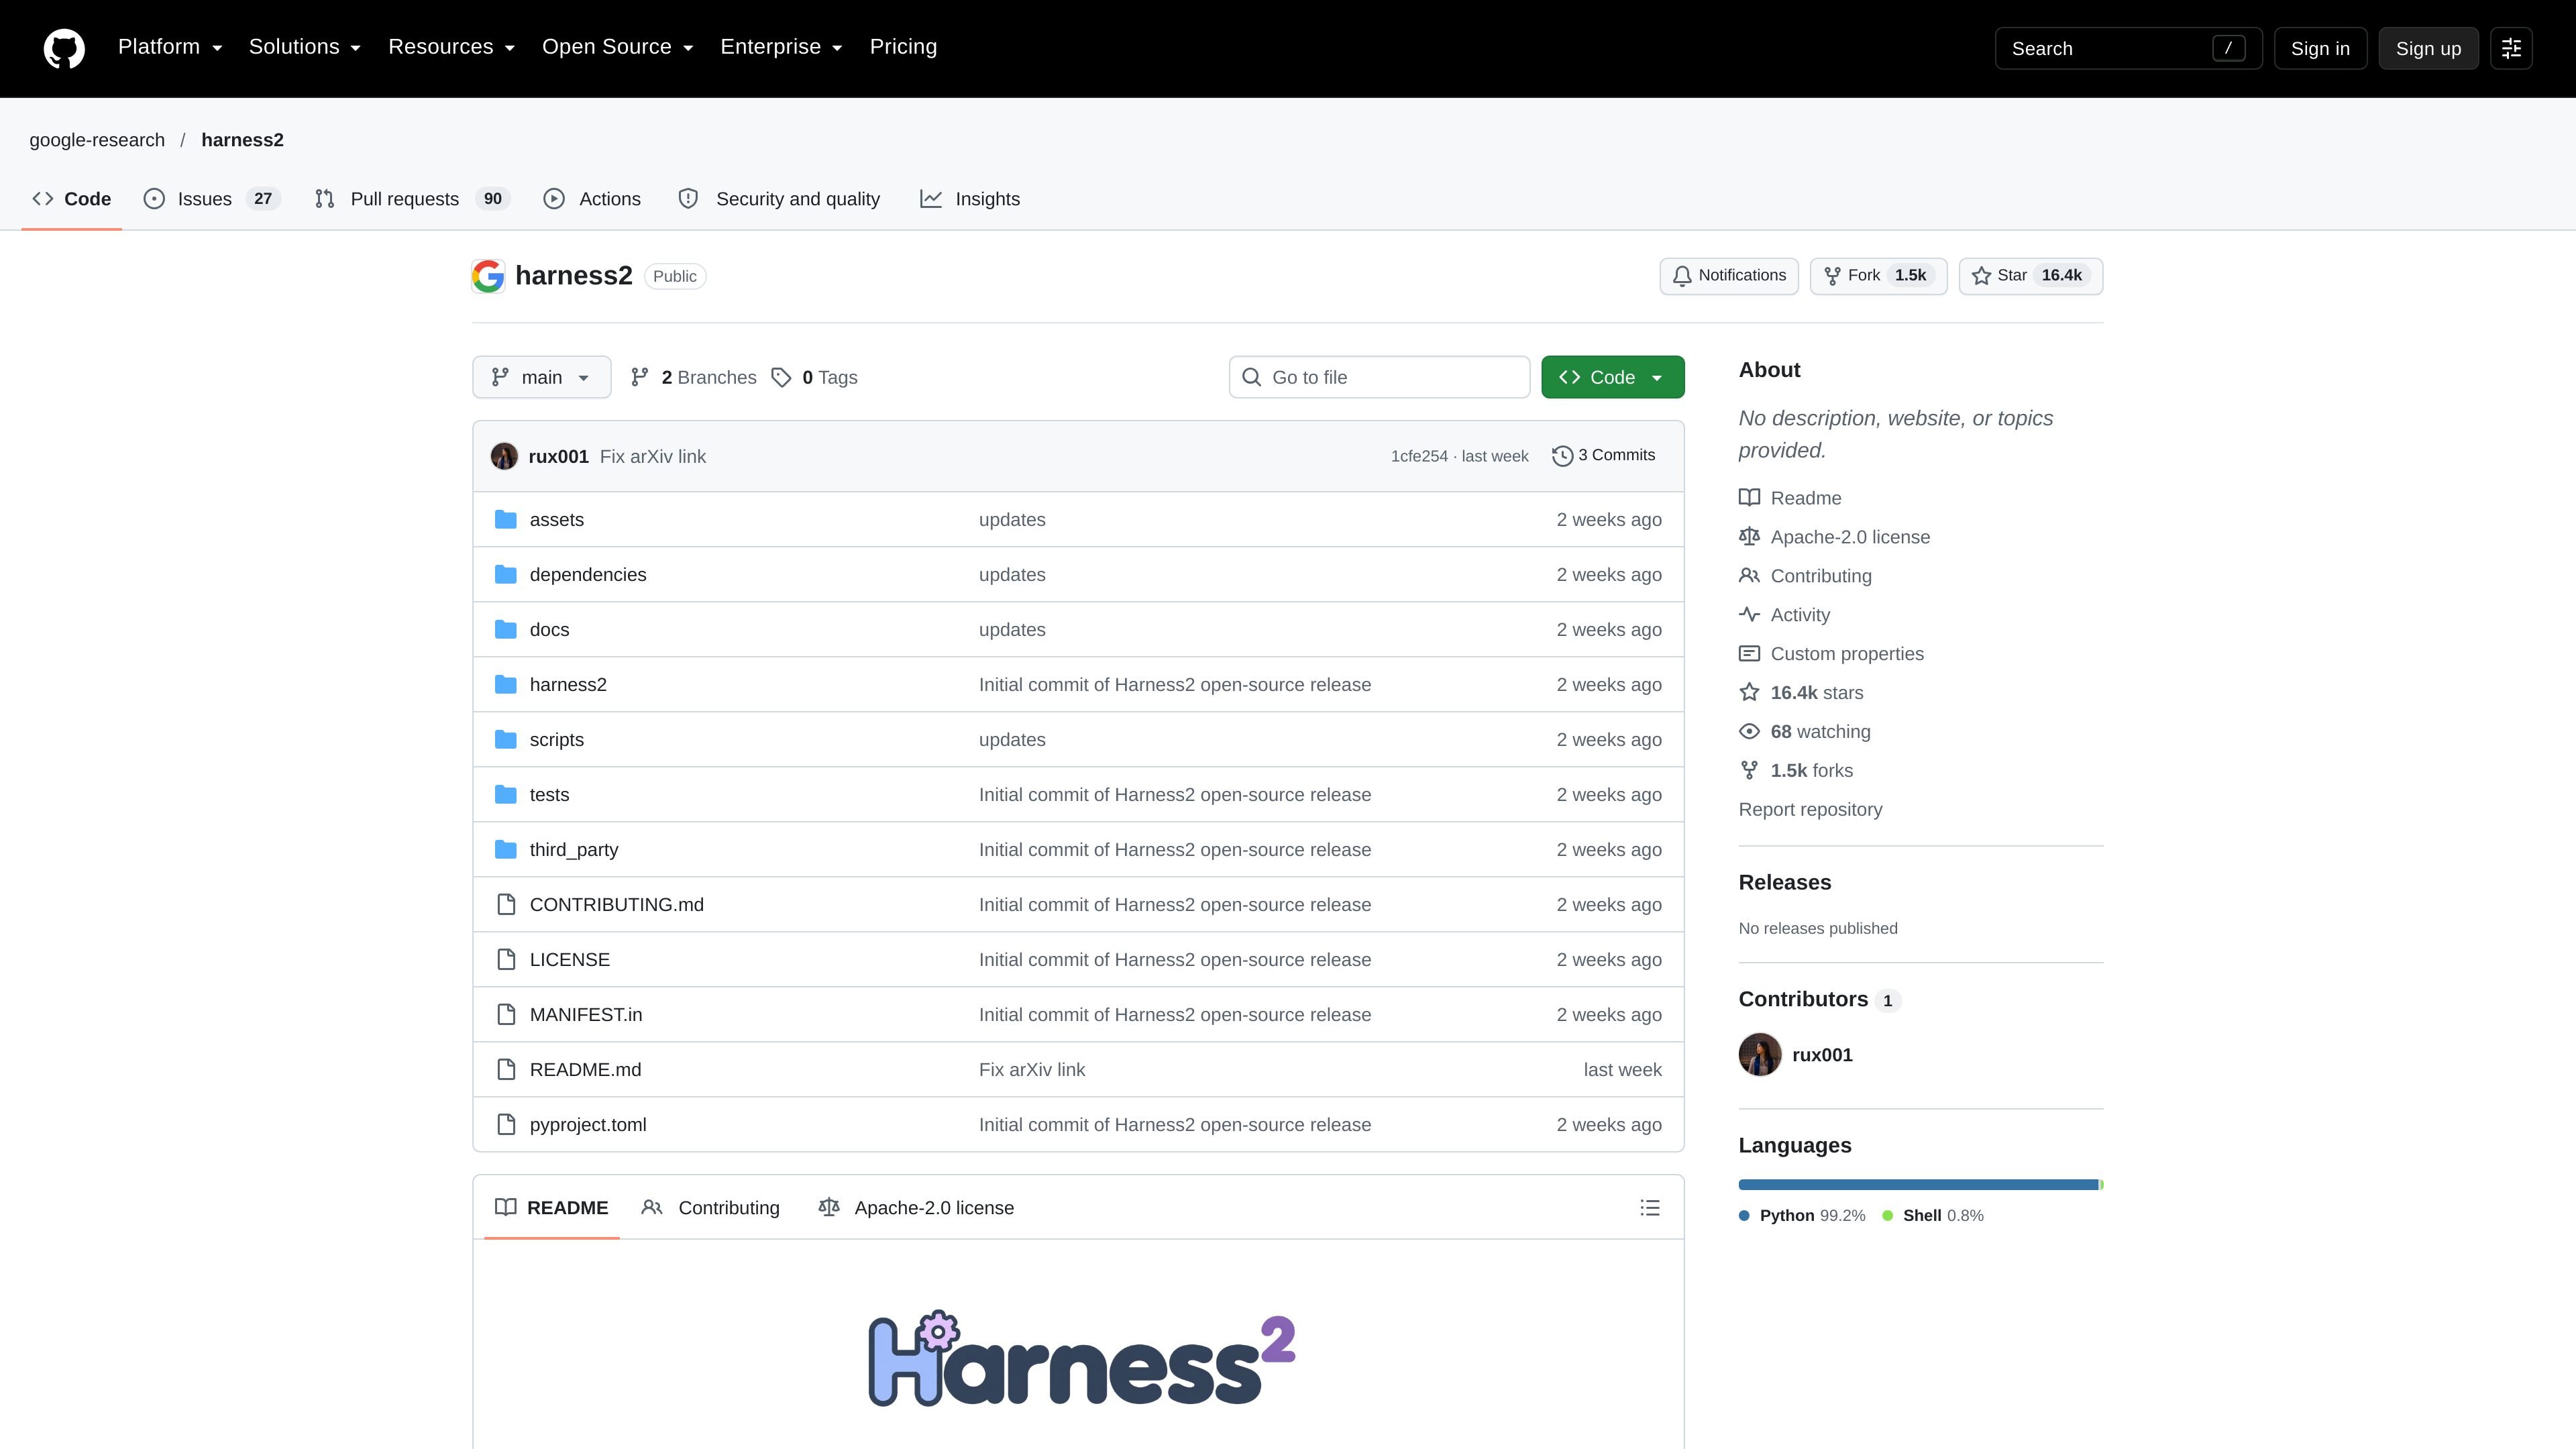
Harness²は、open-worldタスクにおける再帰的なエージェントハーネス化のための、google-researchリポジトリ発のApache-2.0ライセンスのフレームワークです。モデルの重みを変更するのではなく、プロンプト、ツール、メモリ、スキル、オーケストレーションなど、固定モデルの周辺にある編集可能な要素を改善することに重点を置いています。
タスクレベルのワークフローではPropose-Probe-Composeを使用します。現在のタスクで候補となるハーネスの編集をテストし、それらの実行から得た行動上の証拠を使って改善案を構成します。もう1つの永続的なレベルでは、採用されたハーネスと証拠に裏付けられた教訓を記録し、後続のタスクが以前の改善作業を活用できるようにします。
フレームワークは、周辺のエージェントシステムを編集可能なコンポーネントとして扱います。対象には、システムプロンプト、ガードレール、メモリ、ツールのガイダンス、サブエージェント、スキル、スクリプト、プラグインが含まれます。これらのコンポーネントは、コンテキストの構築、ツール、委任、ツールループ内の動作を制御します。
現在のタスクに対して、Harness²はハーネスの編集を提案し、同じタスクへの影響を検証し、実行時の動作の違いから改善されたハーネスを構成します。文書化されたこの手順では、グラウンドトゥルースによるフィードバックは必要ありません。
タスクの完了後、システムは採用されたハーネスと、証拠に基づく教訓を永続的な改善ハーネスに保持し、後の改善を導くために使用します。
並列再帰では、一般的な候補とドメイン固有の候補を複数探索します。一方、逐次再帰では、改善されたハーネスと蓄積された証拠を後続のステップへ引き継ぎます。`--k` 設定でタスクレベルの再帰予算を制御します。
リリースではデフォルトで OpenCode をサポートし、`--substrate cx` により Codex も使用できます。JobBench、LAB、WorkBuddy-Bench 用のワークフローが含まれています。
コマンドラインワークフローでは、セットアップ、環境チェック、改善、判定、レポート作成を行えます。結果には、タスク概要、成果物、採用されたハーネス、振り返りメモ、評価出力が保持されます。
ベンチマークのセットアップ、ランナー、判定、レポートの各コマンドを使用して、JobBench の業務タスクに対する制御された改善実験を実行し、設定したハーネスの動作を比較します。
法務業務のベンチマークタスク向けに LAB 統合を使用します。文書化されたセットアップには、このベンチマークに必要な Pandoc と Poppler の依存関係が含まれています。
オフィス、ウェブ、コードのタスク向けに WorkBuddy-Bench のサブセットを実行します。文書化されたワークフローでは Docker が必要で、セットアップ後のコマンドに選択したサブセットが引き継がれます。
並列再帰で候補となるハーネスの変更を幅広く探索するか、逐次再帰で1つの改善経路を反復的に深掘りします。広さと累積的な改善のどちらを重視するかが重要な実験に適しています。
モデルを使用するベンチマーク実行を設定する前に、ローカルデモから始め、決定論的なエディターと実際のPython実行を使って両方の再帰モードを動作確認します。
ベンチマーク実行には、プロジェクトで Linux と Python 3.12 が指定されています。Python パッケージは Python 3.13 にも対応しています。文書化されているセットアップでは、uv、Node.js 20 以降、Google Cloud CLI も必要です。ベンチマークによっては追加の依存関係があります。
リポジトリでは JobBench、LAB、WorkBuddy-Bench が文書化されています。ベンチマークは `harness2-setup` でインストールし、改善実行の前に `harness2-check` で確認します。
改善を実行するには `harness2` を使用し、その後 `harness2-judge` と `harness2-report` で評価とレポート作成を行います。`--dry-run` を使うと、モデルを呼び出さずにタスク選択をプレビューできます。評価とレポート作成には、改善実行時と同じベンチマーク、エグゼキューター、タスクサブセット、再帰予算、モード、シードが必要です。
結果は `runs/` 配下に保存され、ベンチマーク別、該当する場合はサブセット別に整理されます。タスク概要、成果物、採用されたハーネス、振り返りメモ、評価結果が含まれます。同じコマンドを繰り返すと実行を再開できます。モデルやタスク選択を変更する場合は、新しい `HARNESS2_RUNS_DIR` が必要です。

CreateOS Sandboxは、FirecrackerマイクロVM上でコードやエージェントのワークロードを実行できる分離型コンピュート環境です。SDK、CLI、MCPで制御可能。

GitBotは、Claude Code、Codex、OpenCodeを活用した再利用可能なコーディングボットを作成できるローカルブラウザワークスペースです。永続スレッドと権限設定で、リポジトリ内の作業を効率化します。
AakarDev AIは、AIプロバイダーのアクセス管理、プロジェクト別設定、ログ、分析を1つのダッシュボードで管理できるチーム向けツールです。BYOKに対応し、OpenAI、Google Gemini、Anthropic、Groq、Mistral AI、Perplexity AIをサポートします。

Trigger.dev chat agentは、リフレッシュやクラッシュ、長時間の会話も維持できる、開発者向けの耐久性あるAIチャットバックエンドです。AI SDKのuseChatに対応し、ターンにタイムアウトがありません。

ByteAskは、C/C++向けのターミナル起点AIコーディングエージェント。リポジトリを編集し、コンパイラやデバッガ、サニタイザ、テストで変更を検証してから差分を表示。無料枠あり。

Epheremは、Lovable、Bolt、v0、Replit、Cursor、Claude CodeなどのAIコーディングツールで構築したWebアプリ向け静的セキュリティスキャナーです。アプリを実行せず、ソースファイルと依存関係を検査し、一般的なセキュリティミスを分類して修正案を提示します。