

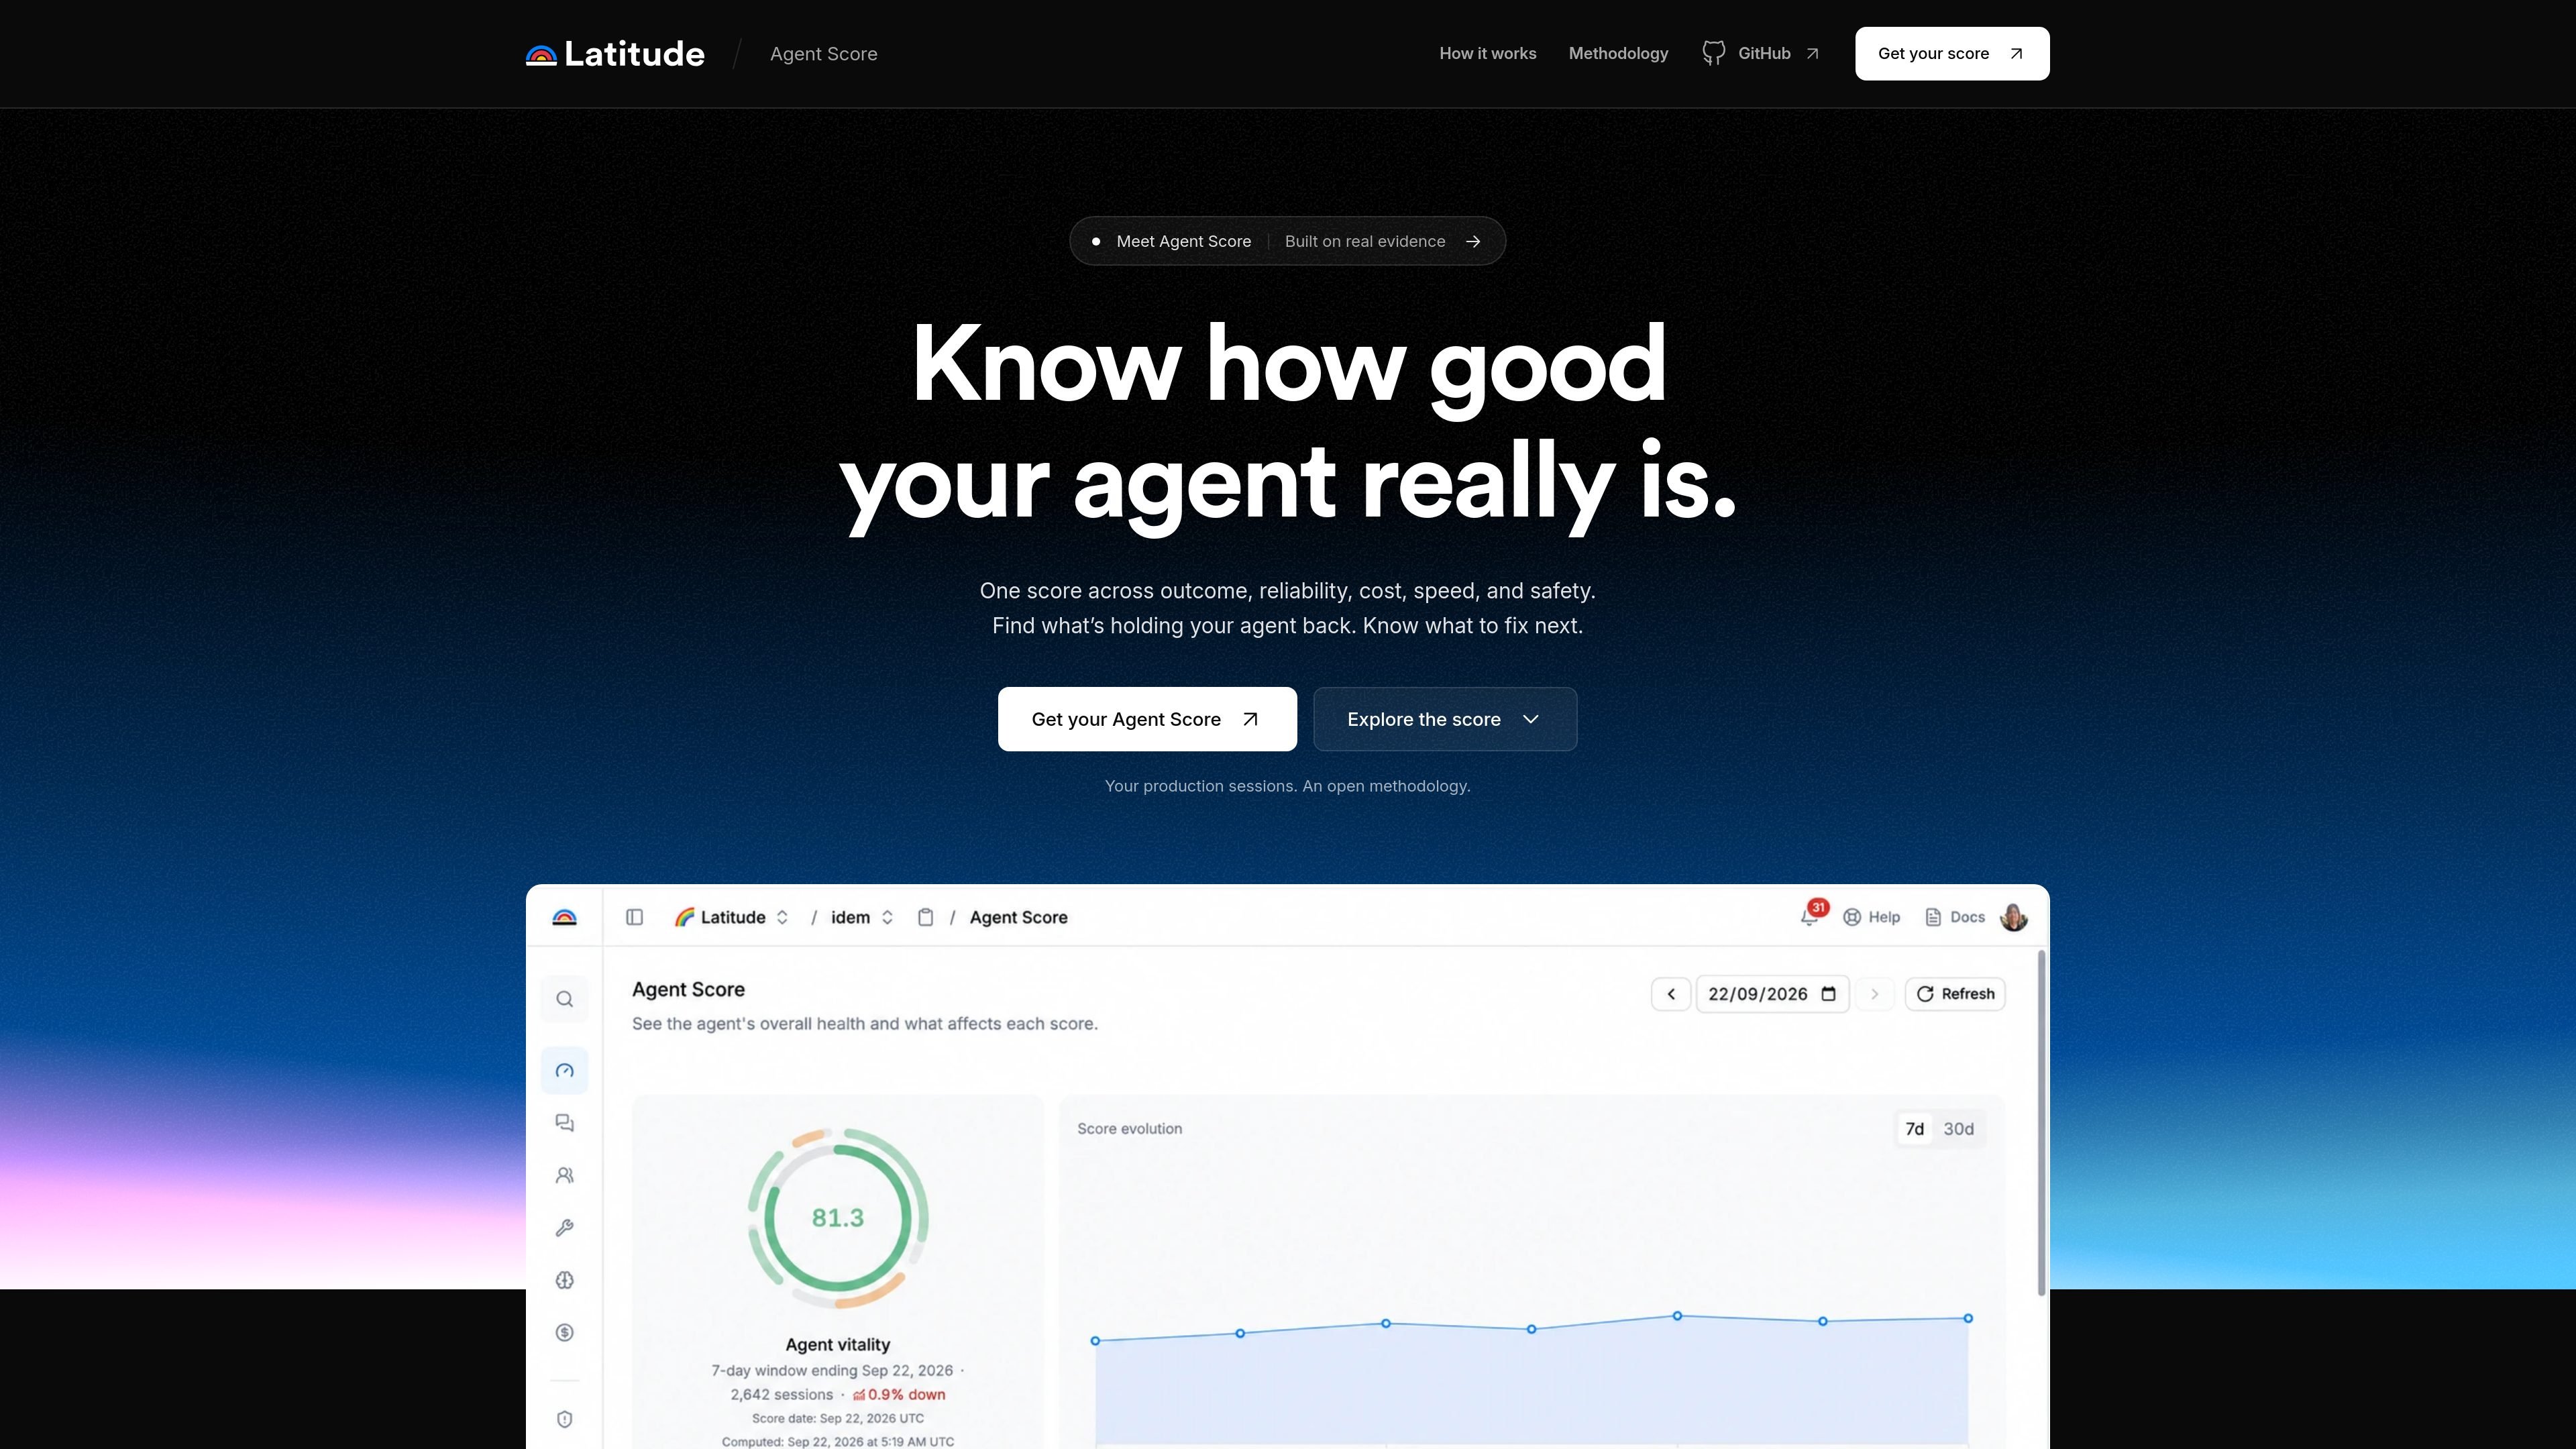
5つの側面によるAgent Score
成果、信頼性、コスト、速度、安全性を1つのビューにまとめ、単一の指標ではなくトレードオフを評価できるようにします。
Latitude Agent Scoreは、AIエージェントを評価するための本番データに基づくツールです。本番環境でトレースされたセッションを、成果、信頼性、コスト、速度、安全性の5つの側面にわたるスコアに変換し、エージェントがタスクを完了したか、運用上の失敗があったか、回避可能なリソースを使用したか、遅延を生じさせたか、確認済みの害を引き起こしたかをチームが把握できるようにします。
このスコアは、単独で使用するベンチマークではなく、調査の出発点として設計されています。チームは結果の根拠となるセッションを確認し、繰り返し発生する失敗パターンを特定して評価に変換し、修正をリリースした後の挙動を比較できます。LatitudeはOpenTelemetryまたは既存のトレースデータを通じてトレースを受け付け、トラフィック、カバレッジ、信頼度の要件を満たした場合にスコアを算出します。
成果、信頼性、コスト、速度、安全性を1つのビューにまとめ、単一の指標ではなくトレードオフを評価できるようにします。
本番セッションを根拠として使用し、95%信頼区間を報告します。根拠が不十分な場合はスコアを表示しません。
スコアの変化や失敗の背景にあるセッションを表示し、集計結果から基盤となる本番環境での挙動を調査できます。
繰り返し発生する問題を特定し、失敗パターンを評価に変換して、その後の本番セッションでも同じ挙動を監視できるようにします。
OpenTelemetryまたは既存のトレースデータを通じて本番トレースを受け付けます。Latitudeのテレメトリを介して、エージェントのメッセージ、コスト、ツール呼び出し、エラーを取得することもできます。
MCPを通じて根拠データをエディター中心のワークフローに接続し、コーディングエージェントが問題のコンテキストを受け取り、リリース後の変更検証を支援できるようにします。
5つの側面を組み合わせて、リリースによって実際のタスク完了率が向上したか、新たな信頼性、コスト、速度、安全性の問題を生じさせていないかを確認します。
スコアの低下や繰り返し発生するシグナルから、影響を受けた本番セッションへ移り、個別のログを確認するのではなく、共通する失敗挙動を特定します。
本番環境で検証済みの失敗を評価に変換し、その後のセッションで追跡して、修正の効果が持続しているかを確認します。
MCPを通じて、関連する問題のコンテキスト、サンプルトレース、ワークスペースへのリンクをコーディングエージェントに提供し、修正をデプロイした後のエージェントの挙動を検証します。
Agent Scoreは、本番セッションを成果、信頼性、コスト、速度、安全性の5つの側面で評価します。エージェントのパフォーマンスに影響している要因と、次に調査すべき根拠に基づく改善点を把握するための機能です。
OpenTelemetryを通じて本番セッションを接続するか、既存のトレースを取り込みます。Latitudeが受信した根拠データを処理し、スコアの算出条件を満たしているか確認します。
スコアは、5つの側面すべてで必要なトラフィック、カバレッジ、信頼度の条件を満たした後にのみ表示されます。Latitudeによると、少なくとも1,000件の適格なセッションが必要で、根拠データは7日、14日、21日、28日のいずれかの条件を満たす週単位の期間全体をカバーしている必要があります。
各スコアには95%信頼区間が含まれます。根拠データが不十分な場合、Latitudeはスコアをまだ表示しません。
Latitudeには無料のStarterプランと有料のProプランがあり、クレジット量、保持期間、デプロイ、ロール、サポートをカスタマイズできるEnterpriseのオプションもあります。料金と上限はプランによって異なります。

ByteAskは、C/C++向けのターミナル起点AIコーディングエージェント。リポジトリを編集し、コンパイラやデバッガ、サニタイザ、テストで変更を検証してから差分を表示。無料枠あり。

Manta AIは、URLからアプリの挙動を把握し、回帰を検出し、スクリプトやセレクタ管理なしでテストを生成できる自律型Webアプリテストツールです。

EAS Observeは、ExpoとReact Nativeアプリ向けの本番パフォーマンス監視ツールです。Expoダッシュボードで起動メトリクス、セッションのタイムライン、リリースマーカー、エラーを確認できます。

Tracciaは、LangChain、CrewAI、OpenAI Agents SDK、AutoGen、LlamaIndex対応のエージェント可観測性・ガバナンス基盤。OpenTelemetryネイティブのトレース、ポリシー強制、プロンプト評価、監査証跡を提供します。
Hopliteは、リポジトリの文脈とローカル設定を取り込んだ隔離サンドボックスでソフトウェア作業を実行したいチーム向けのクラウドコーディングエージェントプラットフォームです。Pro、Scale、Enterpriseプランを提供。

CmdRoundは、Claude Codeを使った実際のコーディング課題で候補者を評価する採用担当者向けエンジニアリング評価ツール。判断、エージェントとのやり取り、テスト結果を時系列で再生し、構造化スコアカードで確認できます。