
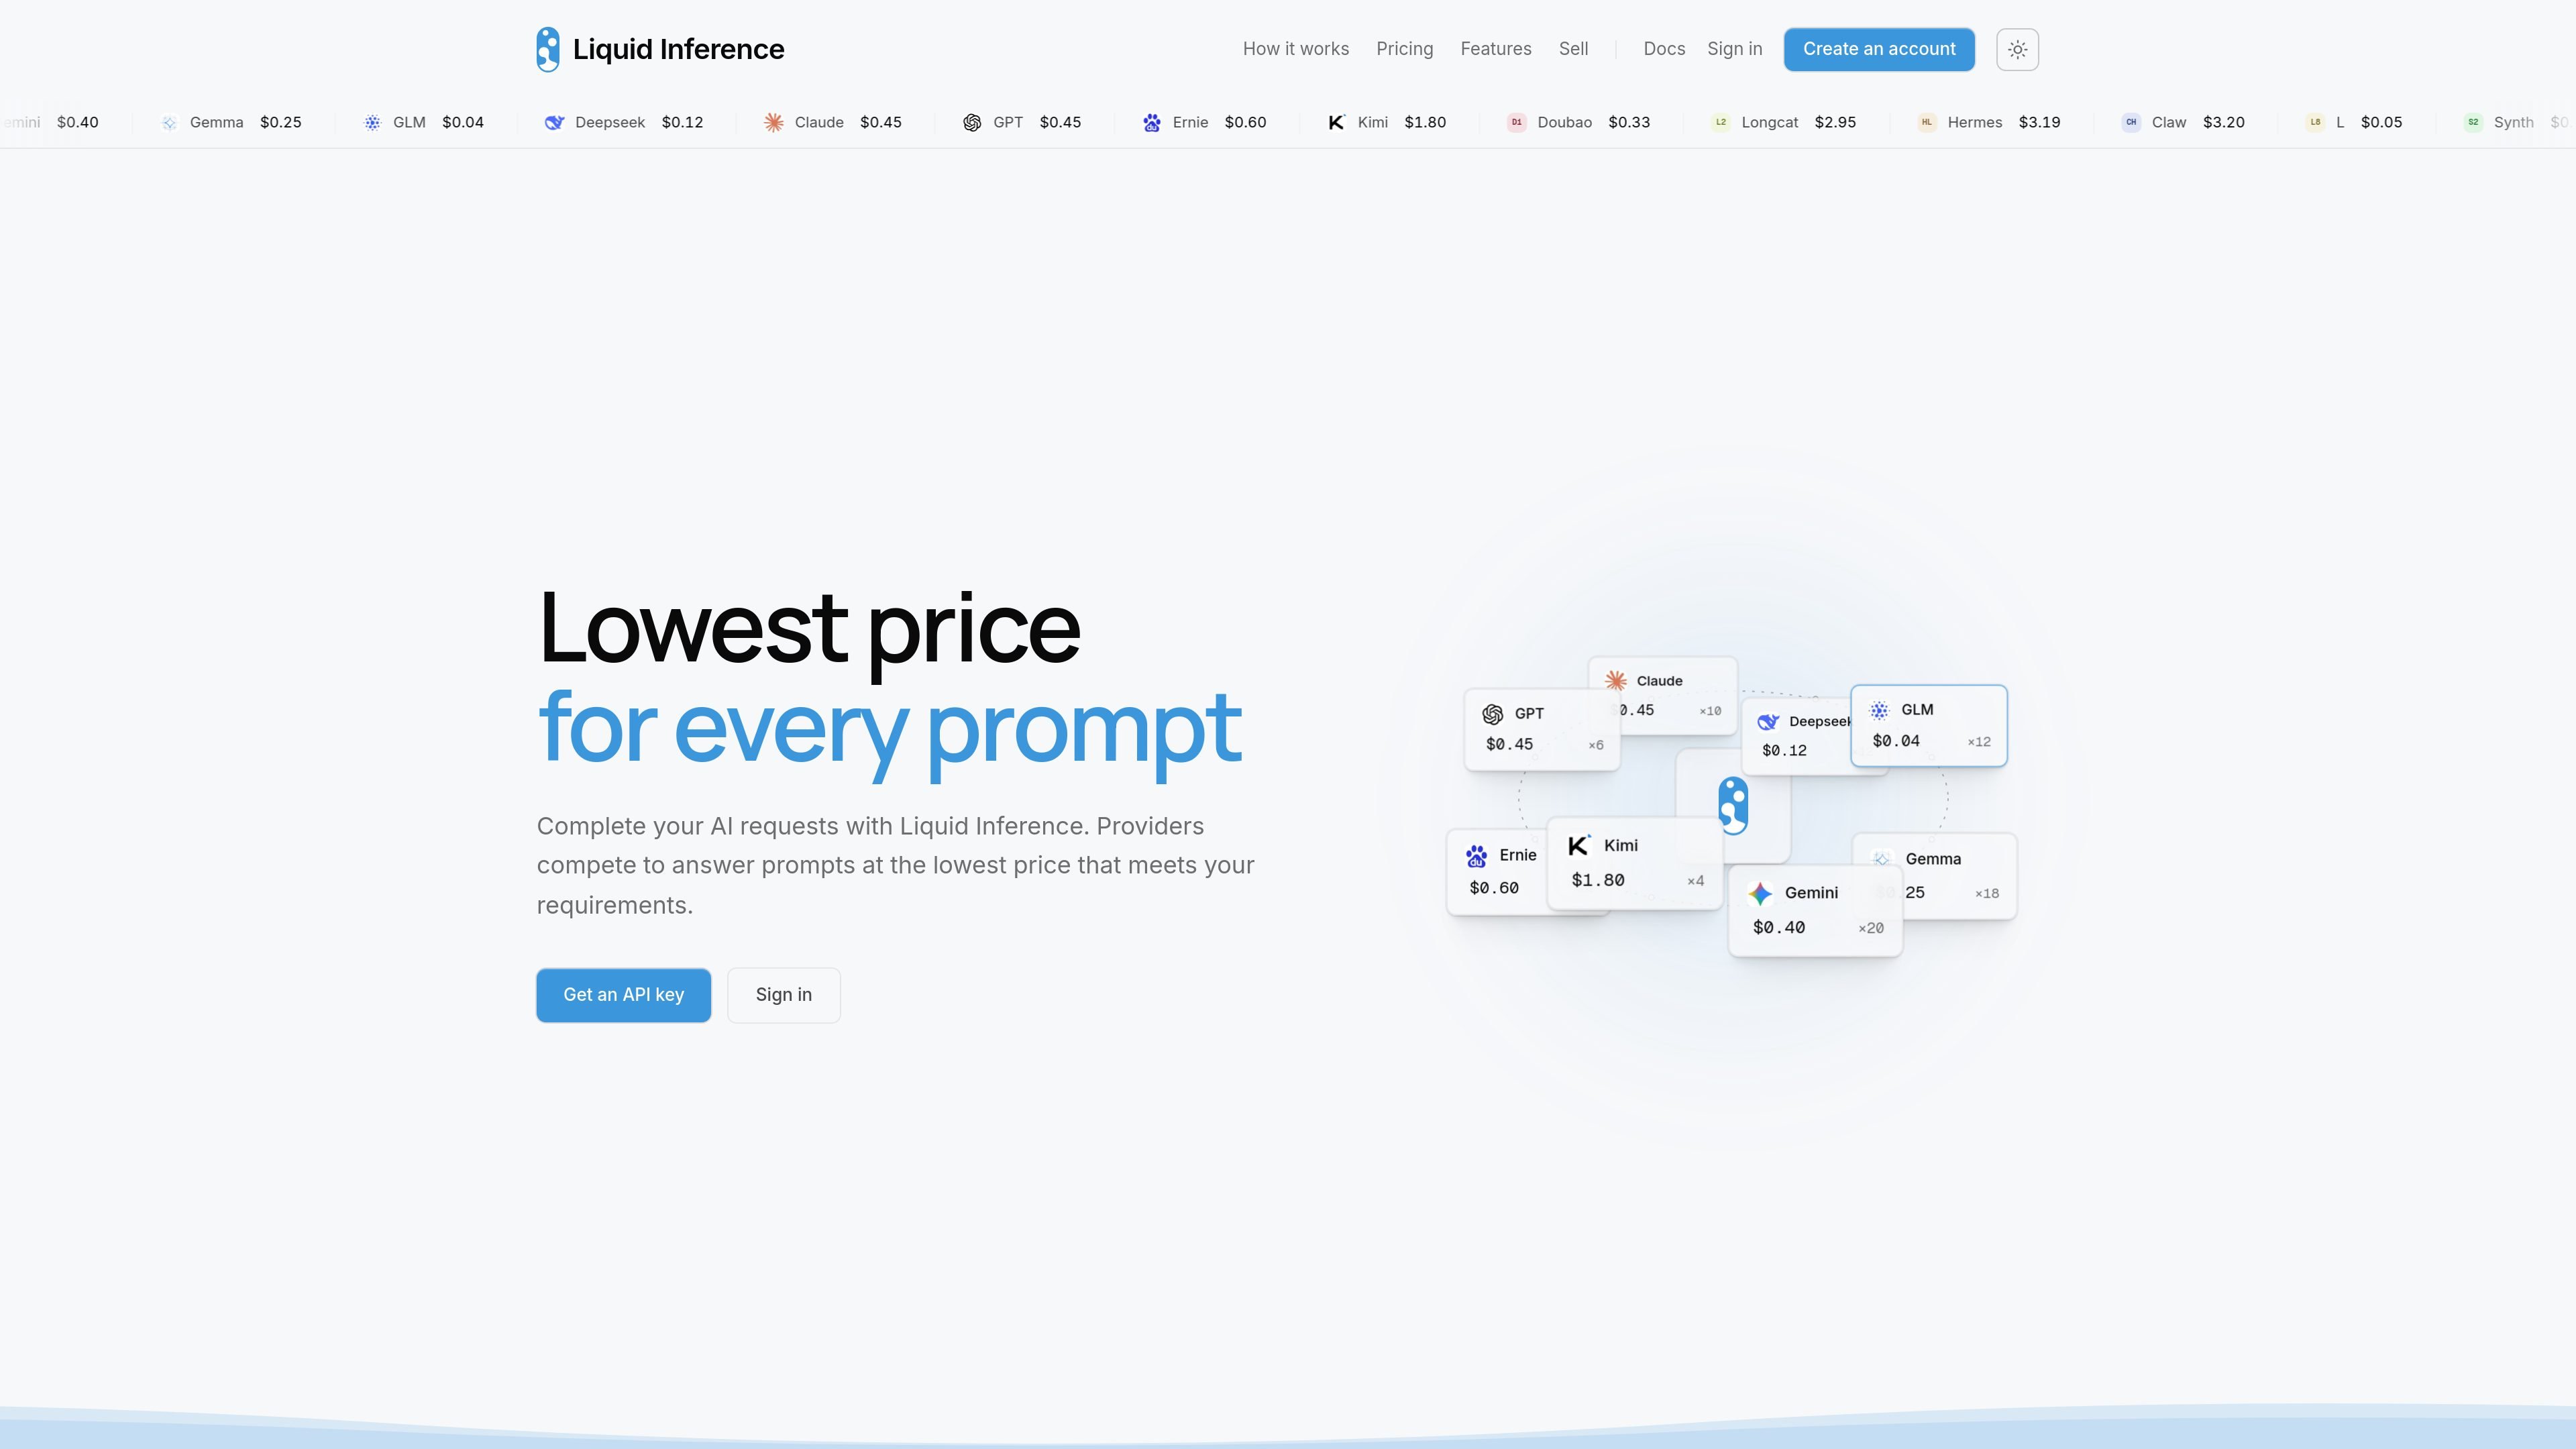
リクエストごとのプロバイダーオークション
プロバイダーは各モデルについてトークン単位の価格を提示し、顧客が選択したルールを満たす中で最も低価格のプロバイダーにリクエストが送信されます。
Liquid Inferenceは、大規模言語モデルのリクエスト向けの推論ルーター兼オークション取引所です。複数のプロバイダーをリクエストごとに競争させ、顧客が指定したモデル、地域、速度、最低品質の要件を満たす中で、最も低価格のオファーを選択します。
このサービスは既存のAPIワークフローに組み込めるよう設計されています。サイトでは、Liquid Inference APIキーを使用し、1つのベースURLからOpenAI Chat CompletionsとAnthropic Messagesを利用する方法が説明されています。また、推論コストを評価・管理する顧客向けに、リクエストコスト情報、プロバイダーの品質測定値、市場価格の履歴も提供します。
プロバイダーは各モデルについてトークン単位の価格を提示し、顧客が選択したルールを満たす中で最も低価格のプロバイダーにリクエストが送信されます。
顧客は、対象プロバイダーの適格性を判断するために使用するモデル、地域、速度、最低品質の要件を指定できます。
生成開始前に価格上限を設定するため、最初のトークンが生成される前にリクエストの最大コストを把握できます。課金は生成されたトークンに基づき、入力トークンは別途価格設定されます。
OpenAI Chat CompletionsとAnthropic Messagesに共通のベースURLを提供しているため、互換性のある既存クライアントでは、リクエストワークフローを作り直すことなくエンドポイントとAPIキーを変更できます。
Liquid Inferenceによると、標準ベンチマークを使ってプロバイダーを定期的にテストし、その品質測定結果を比較用に公開しています。
顧客はリクエストごとの明細コストを確認し、モデルの現在価格や過去価格をダウンロードできます。これにより、コストの確認やワークロードを実行するタイミングの検討が可能になります。
OpenAIまたはAnthropic互換の既存アプリケーションを持つチームは、APIのベースURLとAPIキーを変更するだけで、クライアントのワークフローを維持しながらプロバイダー間の競争を試せます。
エンジニアリングチームは、コストを重視しながらも、リクエストが運用上または出力上の要件を満たす必要があるワークロードに対して、モデル、地域、速度、最低品質のルールを設定できます。
運用チームや財務チームは、リクエストごとの請求明細を確認し、現在または過去の価格情報を使ってモデルコストを比較し、ワークロードを送信するタイミングを判断できます。
AIインフラストラクチャプロバイダーは、デプロイメントを登録して審査に提出し、エージェントを接続して独自の価格を提示できます。また、提示を停止したり価格を変更したりして負荷を制御できます。
Claude Code、Codex、Cursor、LiteLLM、LangChain、SDKベースのクライアントなど、互換性のあるツールを使用する開発者は、対応するワークフローを共有ルーターエンドポイントに向けることができます。
Liquid Inferenceは、OpenAI Chat CompletionsとAnthropic Messages用のルーターエンドポイントを提供します。サイトによると、既存のクライアントはベースURLを変更し、Liquid Inference APIキーを指定することでサービスを利用できます。
各リクエストについて、プロバイダーが選択されたモデルの価格を提示します。Liquid Inferenceは、モデル、地域、速度、最低品質などの顧客ルールを適用し、それらを満たす最安のプロバイダーへリクエストをルーティングします。
サービスは、生成開始前にリクエストの上限価格を表示します。顧客はリクエストで生成されたトークンに対して課金され、入力トークンは出力トークンとは別に価格設定されます。
サイトには、OpenAI互換およびAnthropic互換のAPIワークフローが記載されており、Claude Code、Codex、Cursor、OpenAI SDK、Anthropic SDK、LiteLLM、LangChain、Vercel AI SDKなどのクライアントやツールが挙げられています。完全な互換性やモデル対応範囲については、ソースに詳細な記載がありません。

Grok 4.7は、ソフトウェア開発や知識業務向けのxAIモデルです。長時間のコーディングや専門的な分析に対応し、Grok Build、Cursor、Grok APIなどで利用できます。入力は100万トークンあたり2ドル、出力は6ドルから。
AakarDev AIは、AIプロバイダーのアクセス管理、プロジェクト別設定、ログ、分析を1つのダッシュボードで管理できるチーム向けツールです。BYOKに対応し、OpenAI、Google Gemini、Anthropic、Groq、Mistral AI、Perplexity AIをサポートします。

BookAIは、書名と著者を提供するだけで、AIを使って本とチャットできるサービスです。

Skills Janitorは、Claude CodeとOpenAI Codexのskillsを監査・追跡・管理するGitHubホストのスラッシュコマンド集。重複、壊れたリンク、未使用skillsを見つけて、自己完結型コマンドで整理できます。

FeelFishは、AI支援の小説執筆向けPCクライアント。キャラクターや世界観の設計、長編の下書き・推敲、物語コンテキストの管理を支援。無料プランと有料プランに対応し、複数の大規模モデルを利用可能。

Benchspanは、AIエージェントの検出、プロンプトインジェクションとデータ流出のリアルタイム防御、リリース前のレッドチーミングを備えたAI agent security platformです。PythonとTypeScript SDKsに対応。