
分頁式 SSD KV 快取
oMLX 會將 KV 快取區塊以 safetensors 格式儲存在 SSD 上,而不是全部只保留在 RAM 中。熱區塊會留在記憶體中,冷區塊會移到磁碟,先前看過的前綴可在不同請求之間,甚至在伺服器重新啟動後重新載入。
oMLX 是一款基於 MLX 的原生 macOS 推論伺服器,供 Apple Silicon Mac 上的本地 LLM 使用。它專為減少編碼代理在工作階段中因上下文失效而反覆重新計算所造成的負擔而設計。
它的主要差異化功能是分頁式 SSD KV 快取,會將快取區塊持久化到磁碟上,使先前使用過的前綴能在不同請求之間快速還原,甚至在伺服器重新啟動後也可以恢復。產品同時加入持續批次處理、多模型服務,以及相容 OpenAI 與 Anthropic 的 API,供本地工具與用戶端使用。
oMLX 會將 KV 快取區塊以 safetensors 格式儲存在 SSD 上,而不是全部只保留在 RAM 中。熱區塊會留在記憶體中,冷區塊會移到磁碟,先前看過的前綴可在不同請求之間,甚至在伺服器重新啟動後重新載入。
伺服器透過 mlx-lm 的 BatchGenerator 處理並行請求,因此多個生成工作不必排在單一請求後方等待。首頁聲稱在 8 倍並發下最高可達 4.14× 的加速。
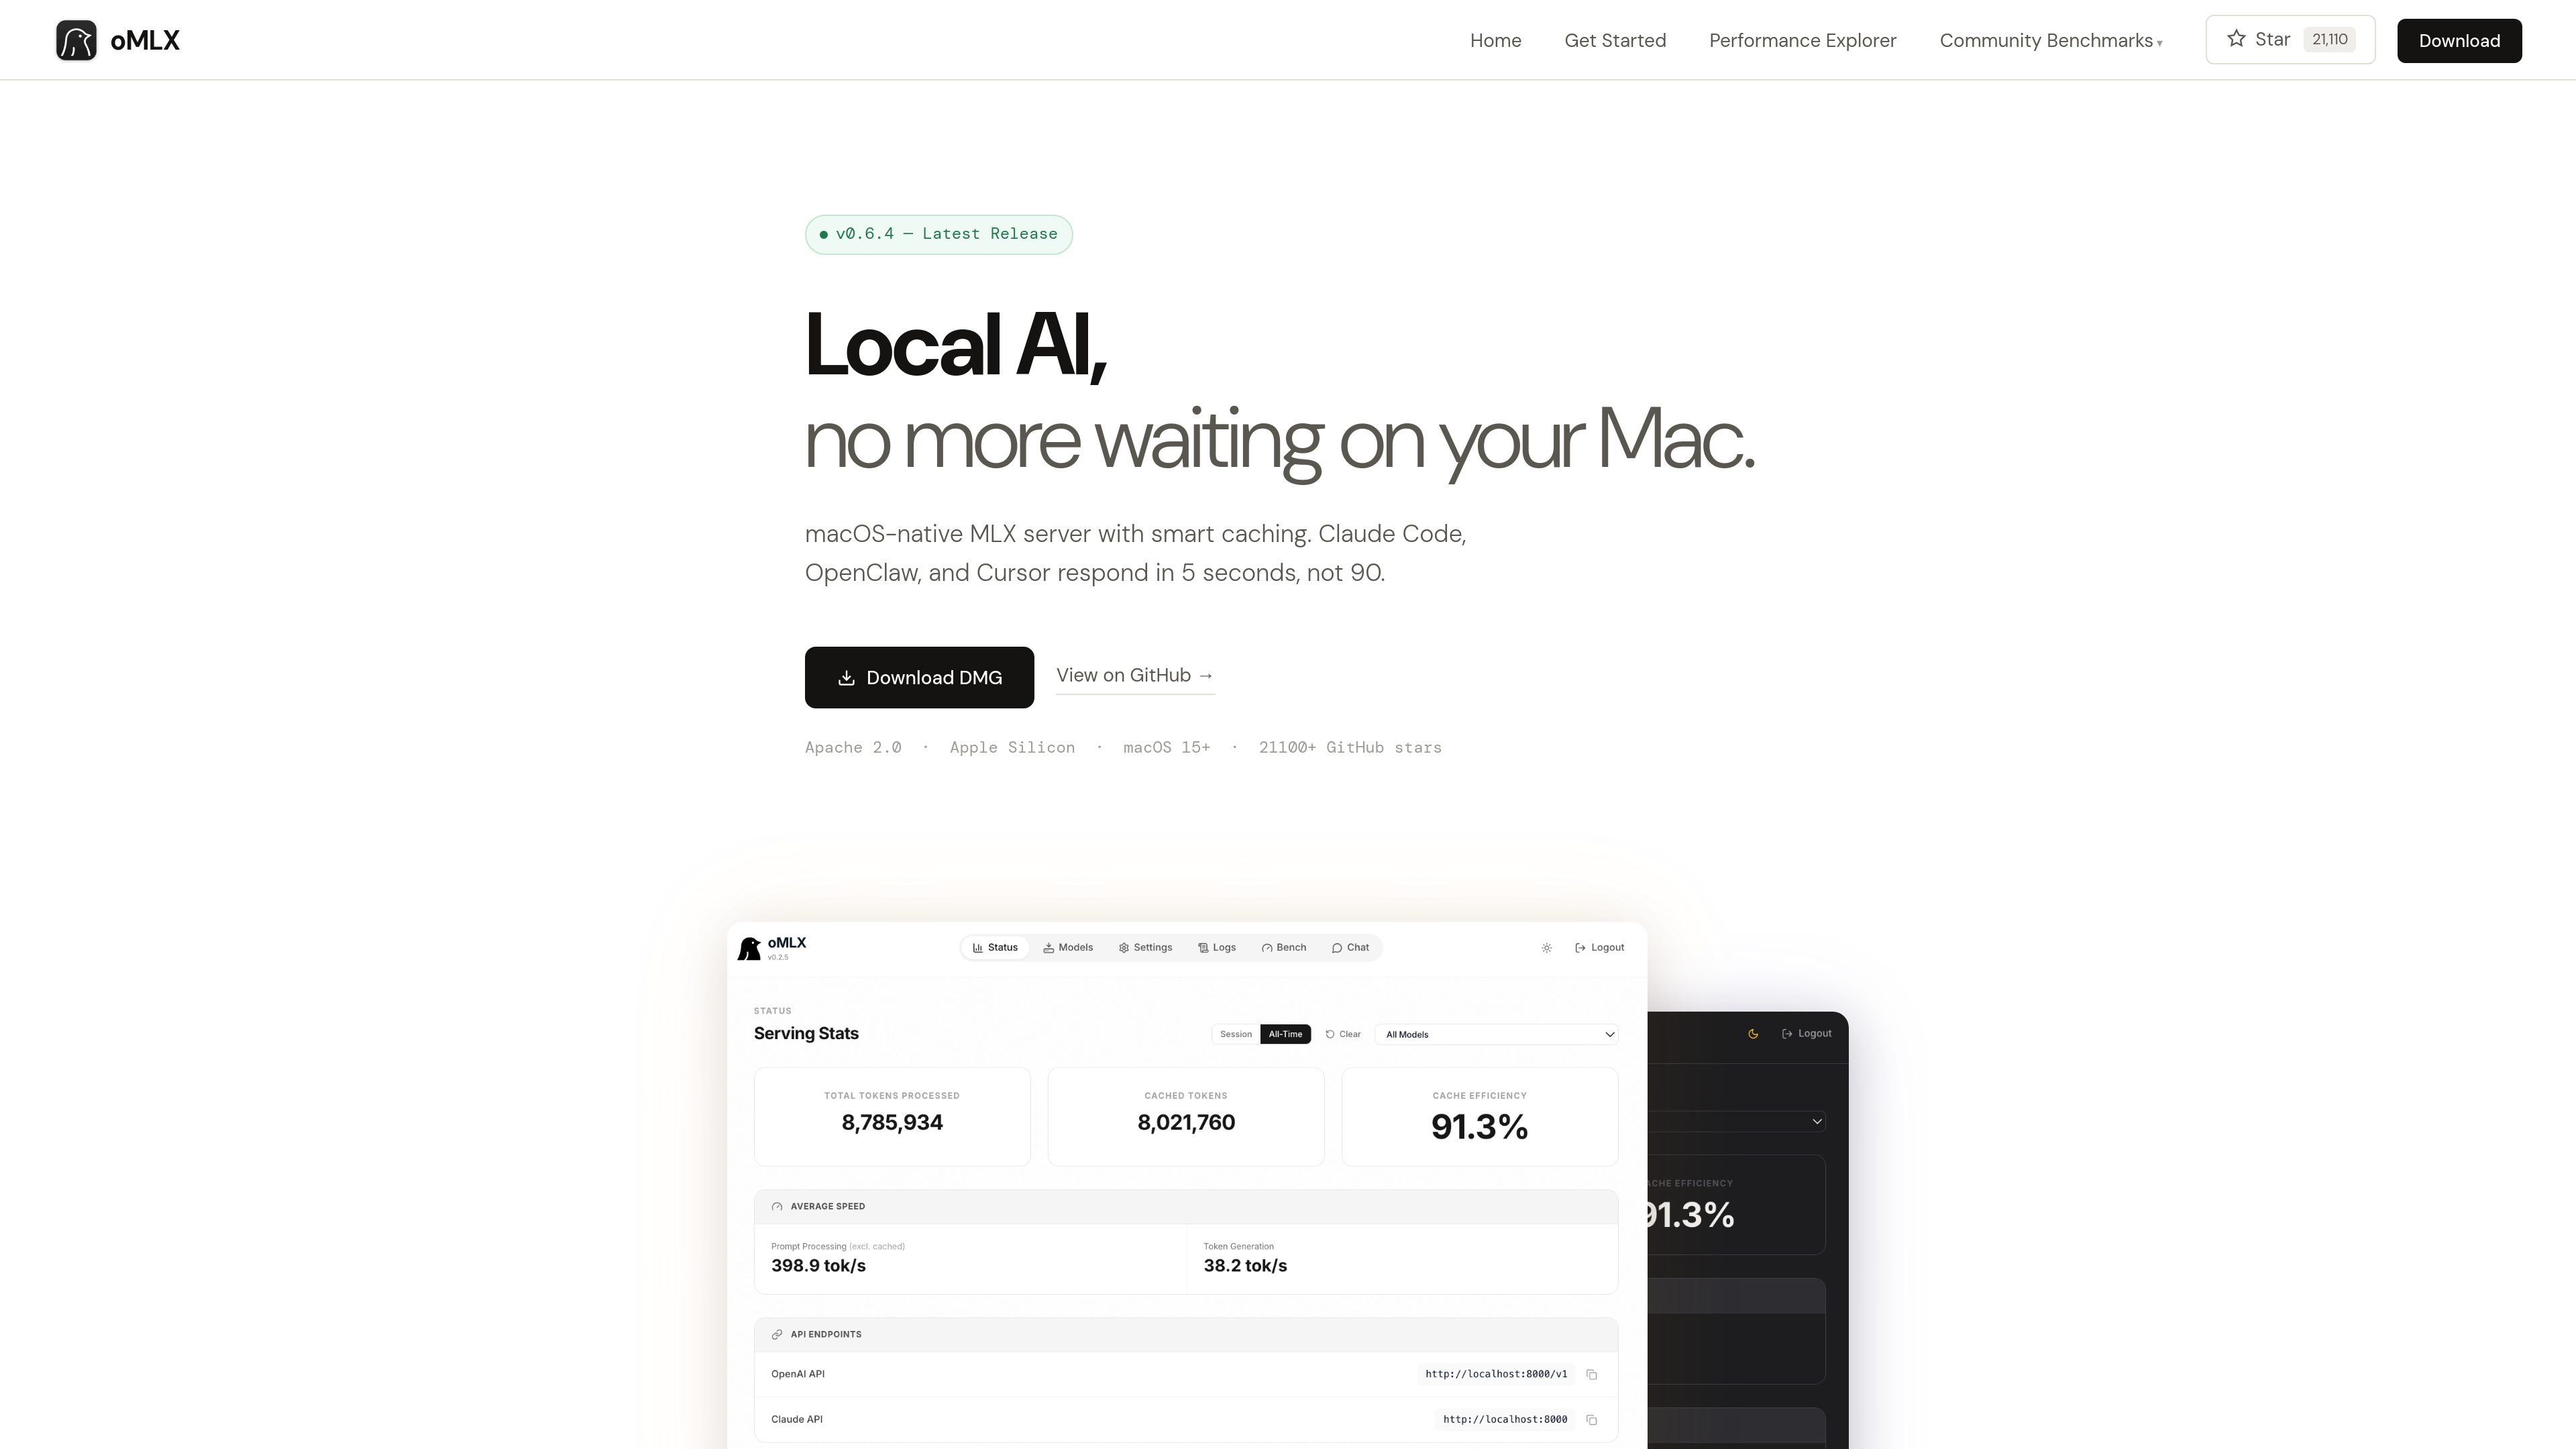
oMLX 內建原生 macOS 選單列應用程式,可用來啟動、停止與監控伺服器。搭配的儀表板支援模型管理、聊天與即時指標,而且應用程式經過簽署、公證,並可自動更新。
儀表板可同時提供多種模型類型,包括 LLM、VLM、embedding 與 reranker。它也支援在記憶體不足時進行 LRU 淘汰,以及從介面瀏覽/下載模型。
oMLX 提供相容 OpenAI 與相容 Anthropic 的 API,包括 /v1/chat/completions 和 /v1/messages。網站表示它可以作為 Claude Code、OpenClaw、Cursor 及其他相容 OpenAI 用戶端的即插即用後端。
產品支援多種主要工具呼叫格式,例如 JSON、Qwen、Gemma、GLM 和 MiniMax,並支援 MCP 整合,以及可設定的工具結果裁剪,用於過大的輸出。
將 oMLX 作為會反覆回到先前上下文的編碼助理之本地後端。SSD 支援的快取旨在保留並還原先前前綴,而不是在代理修正路徑時每次都重新計算。
透過即插即用的 API 支援,將 Claude Code、OpenClaw 或 Cursor 連接到本地 macOS 推論伺服器。網站表示,儀表板可以為每個工具產生 دقیق的設定指令。
在同一台機器上提供多種模型類型,例如用於聊天的 LLM、用於影像感知工作的 VLM,以及用於檢索任務的 embedding 或 reranker 模型。儀表板可讓你在同一處瀏覽、下載與管理模型。
使用選單列應用程式與網頁儀表板來啟動伺服器、監控狀態並查看即時指標,而不必切換到另一個桌面應用程式。這對希望本地推論在工作時持續可用的人很有幫助。
重用 Hugging Face 快取資料夾或 LM Studio 目錄中已存在的模型,然後在本地提供服務,而不需要再次下載。這使得 oMLX 很適合已經在磁碟上保有本地模型庫的使用者。
oMLX 是一款基於 MLX 的原生 macOS 推論伺服器。它提供相容 OpenAI 與 Anthropic 的端點,讓 Claude Code、OpenClaw 和 Cursor 等工具可以連線到本地後端。
來源指出 oMLX 支援執行 macOS 15+ 的 Apple Silicon Mac。最低記憶體需求為 16GB,而若要更舒適地使用較大的模型,建議 64GB 以上。
可以。首頁說 oMLX 可作為 Claude Code、OpenClaw 和 Cursor 的即插即用後端,也能搭配任何在 localhost:8000 上支援 OpenAI 相容的用戶端使用。
不需要。FAQ 表示 oMLX 會讀取標準 Hugging Face 快取,因此已在共用快取位置下載的模型可以重複使用,不必重新下載。它也可以辨識 LM Studio 資料夾與自訂目錄。
網站表示支援任何 HuggingFace 的 MLX 格式模型,包括 LLM、VLM、embedding 與 reranker 模型,並可自動處理數種推理模型格式。

ByteAsk 是專為 C 與 C++ 打造的終端機優先 AI coding agent,先編輯儲存庫再用真實編譯器、除錯器、sanitizer 與測試驗證變更,並提供免費方案與付費方案。

CreateOS Sandbox 是以 Firecracker micro-VM 執行程式與 agent 工作負載的隔離運算環境,支援私有網路、SDK、CLI 與 MCP 程式化控制。

hob 是一個獨立的 coding agents 工作區,整合 agent sessions、終端機、歷史紀錄與後續工作,並維持你既有的工具與供應商設定。適合想保有本機路由、歷史與工作區結構控制權的開發者。

Manta AI 是一款自動化網頁應用測試工具,從 URL 即可開始探索、建立行為地圖,並以自然語言產生測試與回歸檢查,無需撰寫腳本或維護 selector。

SonOf 串接你的 repo 與 PM 工具,審核程式碼庫與產品脈絡,將核准工作轉為可交付的 ticket,並由資深工程師審查,協助創辦人與工程主管快速補足 backlog。

Ghost 是一款終端機 AI 助手,可在命令列中聊天、產生程式碼並執行任務。內建免費模型,支援 Linux、macOS、Windows,且為開源工具。