
ハイブリッド容量のMoE設計
トークンごとに12Bパラメータを有効化する120BパラメータのMixture-of-Expertsアーキテクチャを採用し、モデル全体の容量と、より選択的な計算のバランスを取ります。

NVIDIA Nemotron 3.5 Super VLは、専門的なAIエージェント向けのオープンでカスタマイズ可能なマルチモーダルモデルです。推論、ツール利用、テキスト・画像・文書・動画の理解に対応し、NVIDIA NeMoによる追加学習も可能です。
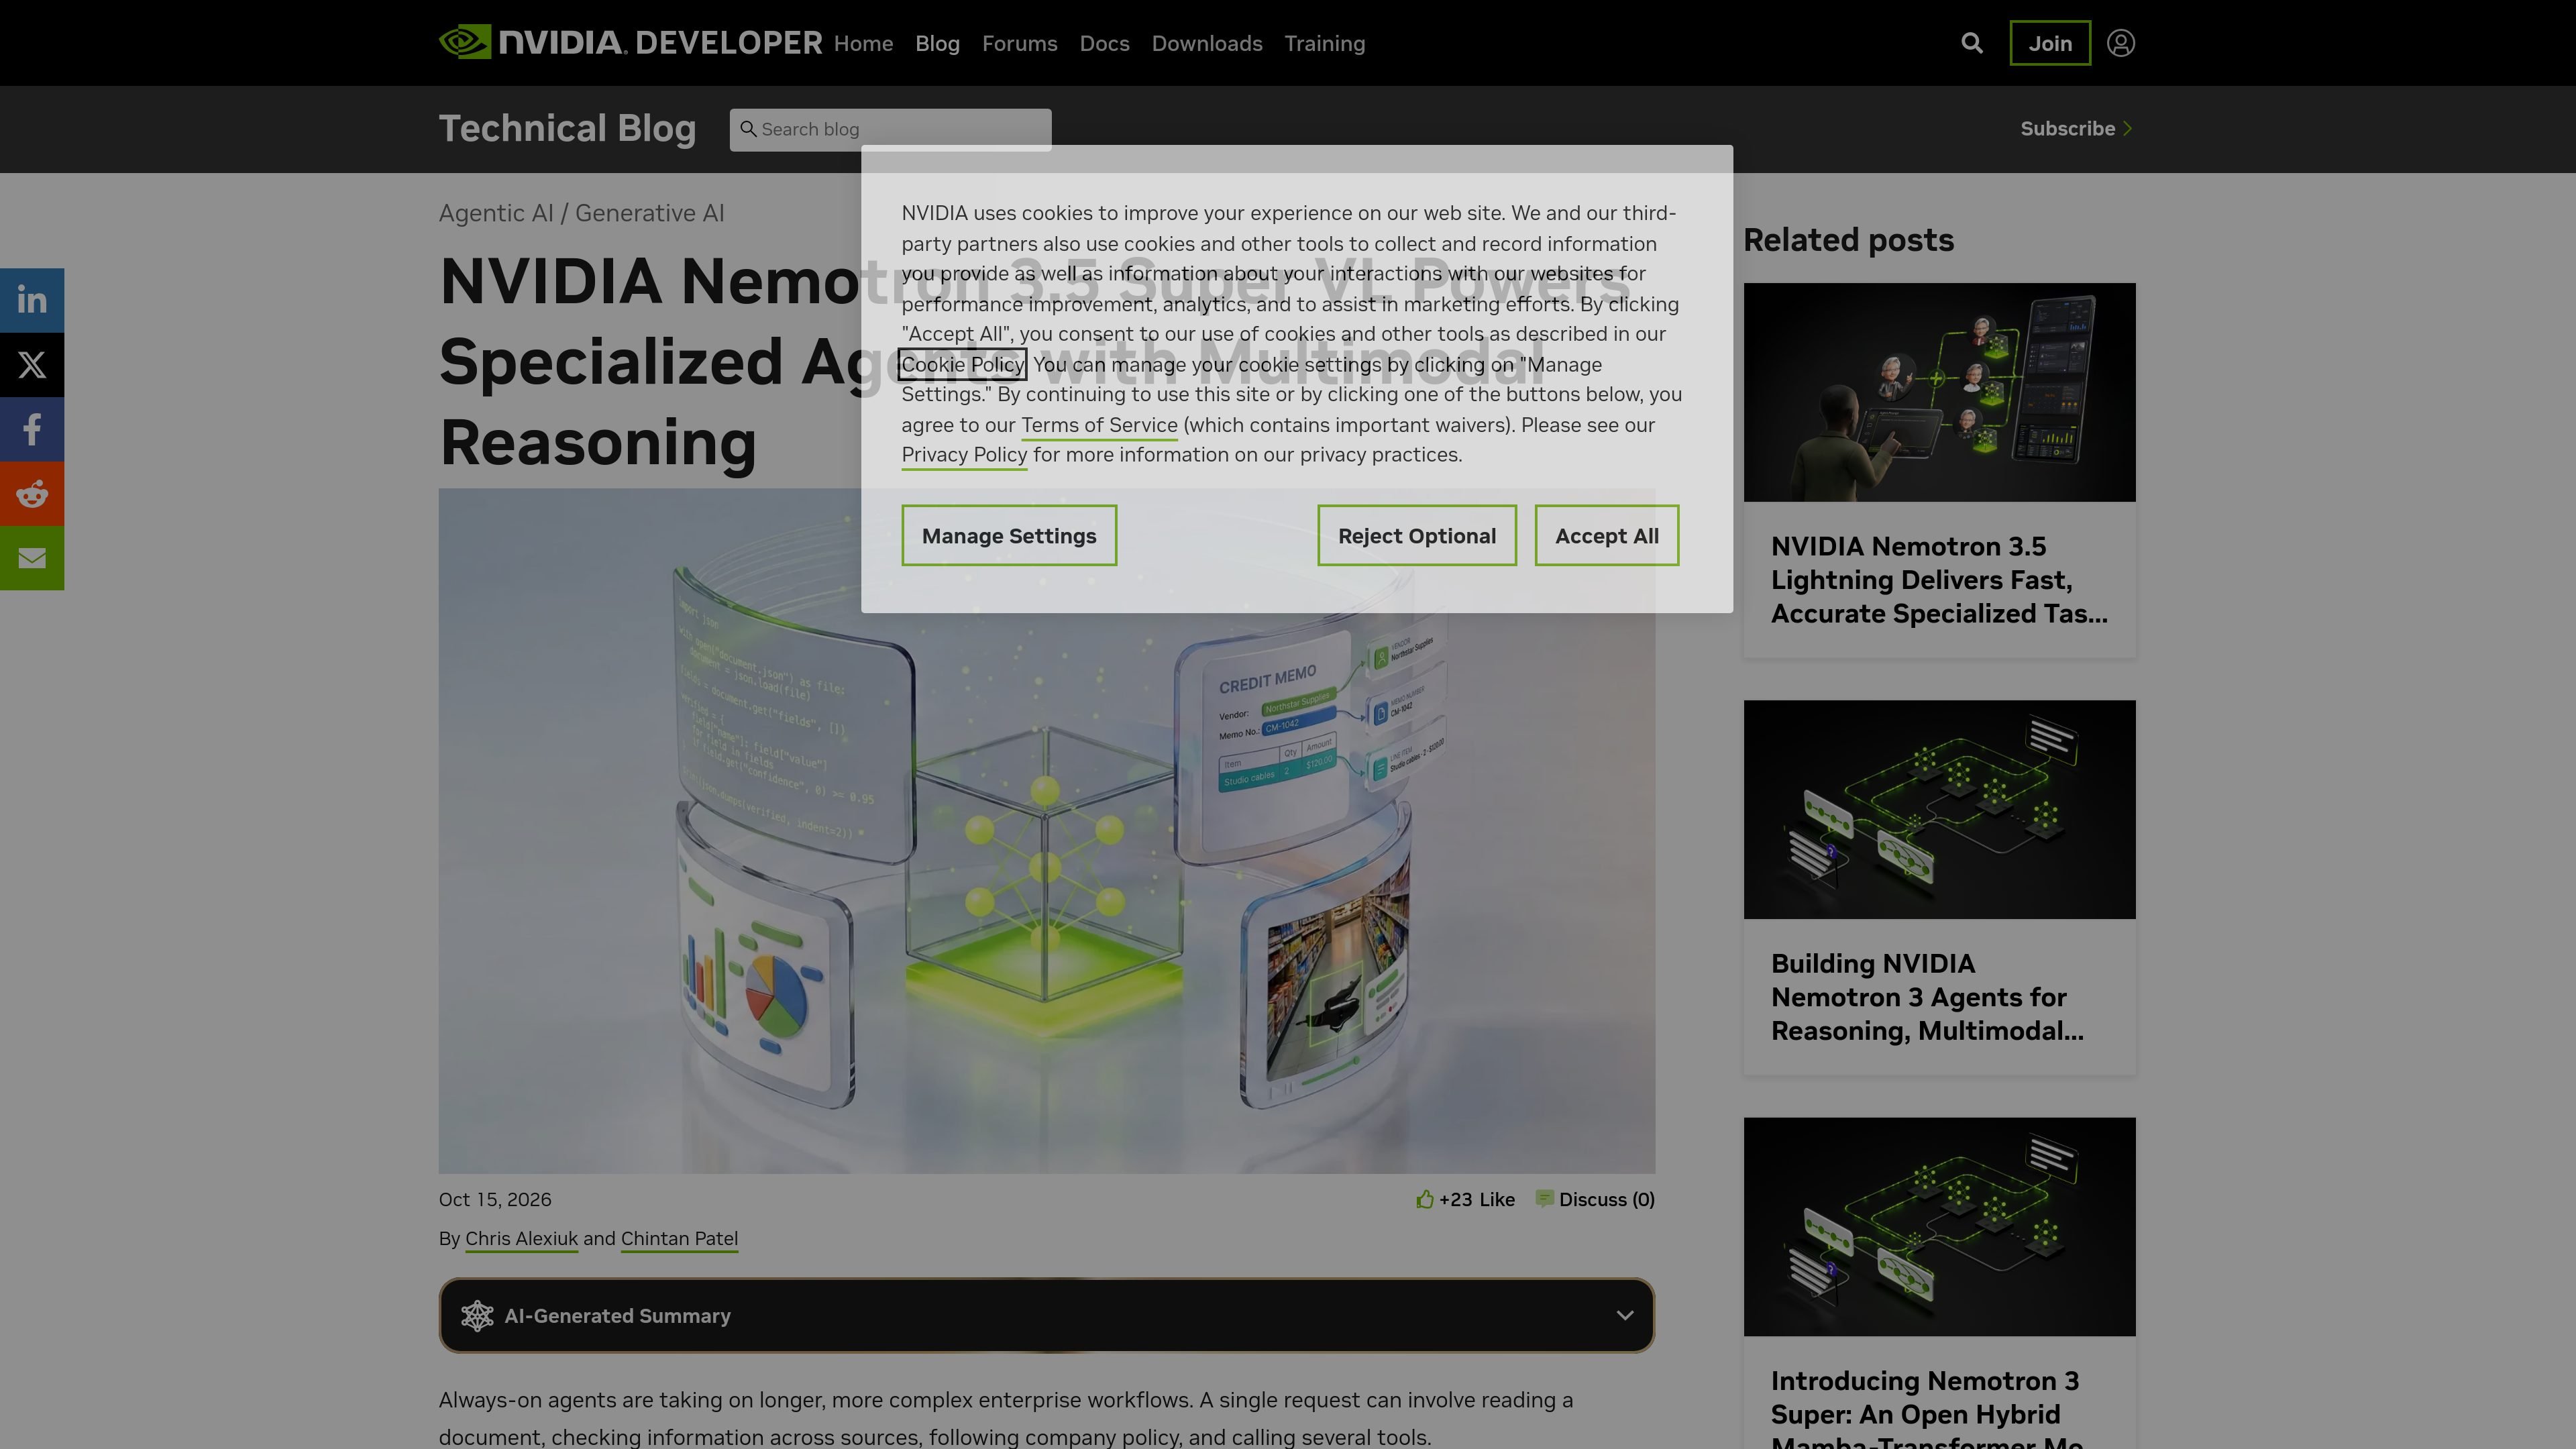
NVIDIA Nemotron 3.5 Super VLは、専門的なAIエージェント向けのオープンでカスタマイズ可能なマルチモーダルモデルです。推論、ツール呼び出し、ポリシー遵守、テキスト、画像、文書、動画の解釈を必要とする多段階のエンタープライズワークフロー向けに設計されています。
120BパラメータのMixture-of-Expertsアーキテクチャを採用し、トークンごとに12Bパラメータを有効化します。より大規模なNemotronシステムでは、マルチモーダル推論コンポーネントとして機能し、大量のテキストタスク向けの小規模モデルや、複雑な計画・オーケストレーション向けの大規模モデルと組み合わせられます。開発者はNVIDIA NeMoを使用して、ドメイン固有のデータ、ツール、業務手順に合わせて適応させることができます。
トークンごとに12Bパラメータを有効化する120BパラメータのMixture-of-Expertsアーキテクチャを採用し、モデル全体の容量と、より選択的な計算のバランスを取ります。
推論、指示追従、ツール利用と、テキスト、画像、文書、動画の理解を1つのモデルに統合します。
表、グラフ、ページレイアウトを解釈する文書ワークフローに加え、動画の検索、レビュー、インシデント分析に対応します。
NVIDIA NeMoを使用して、組織のデータ、ツールインターフェース、業務手順、ポリシーで追加学習できます。
LiLiCorr投機的デコーディング、量子化認識蒸留を伴うNVFP4量子化、マルチトークン予測、コンテキスト再利用を使用して、推論効率の向上を図ります。
ローンチ記事では、Artificial Analysis Intelligence Indexのエージェントタスク向けエンドポイントで毎秒600超の出力トークンを実現し、単一GPU上で同サイズカテゴリの他のオープンモデルより最大5倍高いスループットを報告しています。結果は、記載されたベンチマークとデプロイ条件に依存します。
推論とツール利用を組み合わせたワークフローで、コードのテストと検証、エラー分析、修正の推奨を行います。
ウェブサイトを横断して検索し、複数のソースから情報を関連付け、結果を生成する前に回答を検証します。
表、グラフ、ページレイアウトを読み取り、複雑な文書から情報を抽出して要約やレポートを生成します。
脆弱性を特定し、セキュリティ脅威をトリアージして、チームが修復作業の優先順位を決められるようにします。
検索、コンテンツレビュー、インシデント分析のために、動画から情報を抽出します。
Nemotron 3.5 Super VLは、推論、ツール利用、テキスト・画像・文書・動画の理解を組み合わせた、専門的で多段階のエージェントワークフローを想定しています。例として、コーディング、ウェブ調査、文書インテリジェンス、サイバーセキュリティ、動画分析などがあります。
NVIDIA NeMoを使用し、組織のデータ、ツール、ポリシー、ワークフローで追加学習できます。ソースでは、カスタマイズ手法として教師ありファインチューニング、低ランク適応、強化学習も挙げられており、オープンデータセットはHugging Faceで公開されています。
このモデルは、推論、指示追従、ツール利用、マルチモーダル理解を1つのモデルに統合しています。そのため、これらの機能についてテキストモデルと視覚言語モデルを別々に用意しなくても、ワークフローでテキストと視覚入力を処理できます。
ソースでは、LiLiCorr投機的デコーディング、量子化認識蒸留を伴うNVFP4量子化、マルチトークン予測、コンテキスト再利用などによるデプロイ最適化が説明されています。最適化されたデプロイにはNVIDIA NIMが案内されていますが、提供された情報には、完全なデプロイ構成や対応プラットフォーム一覧は記載されていません。
AakarDev AIは、AIプロバイダーのアクセス管理、プロジェクト別設定、ログ、分析を1つのダッシュボードで管理できるチーム向けツールです。BYOKに対応し、OpenAI、Google Gemini、Anthropic、Groq、Mistral AI、Perplexity AIをサポートします。

Benchspanは、AIエージェントの検出、プロンプトインジェクションとデータ流出のリアルタイム防御、リリース前のレッドチーミングを備えたAI agent security platformです。PythonとTypeScript SDKsに対応。

CreateOS Sandboxは、FirecrackerマイクロVM上でコードやエージェントのワークロードを実行できる分離型コンピュート環境です。SDK、CLI、MCPで制御可能。

GitBotは、Claude Code、Codex、OpenCodeを活用した再利用可能なコーディングボットを作成できるローカルブラウザワークスペースです。永続スレッドと権限設定で、リポジトリ内の作業を効率化します。

Codex Plugins は、再利用可能なスキル、アプリ連携、MCPサーバーを Codex app や Codex CLI で使えるワークフローにまとめます。接続サービスの作業や共有チームワークフローを拡張できます。

Grok 4.7は、ソフトウェア開発や知識業務向けのxAIモデルです。長時間のコーディングや専門的な分析に対応し、Grok Build、Cursor、Grok APIなどで利用できます。入力は100万トークンあたり2ドル、出力は6ドルから。