
ページングされたSSD KVキャッシュ
oMLXはKVキャッシュブロックをRAMにのみ保持する代わりに、safetensors形式でSSD上に保存します。ホットブロックはメモリに残り、コールドブロックはディスクへ移動し、以前に見たプレフィックスはリクエスト間やサーバー再起動後でも復元できます。
oMLXは、Apple Silicon搭載Mac向けにMLXで構築されたネイティブmacOS推論サーバーです。SSD対応KVキャッシュ、連続バッチ処理、OpenAI・Anthropic互換エンドポイントを搭載し、Claude CodeやCursorなどに対応します。
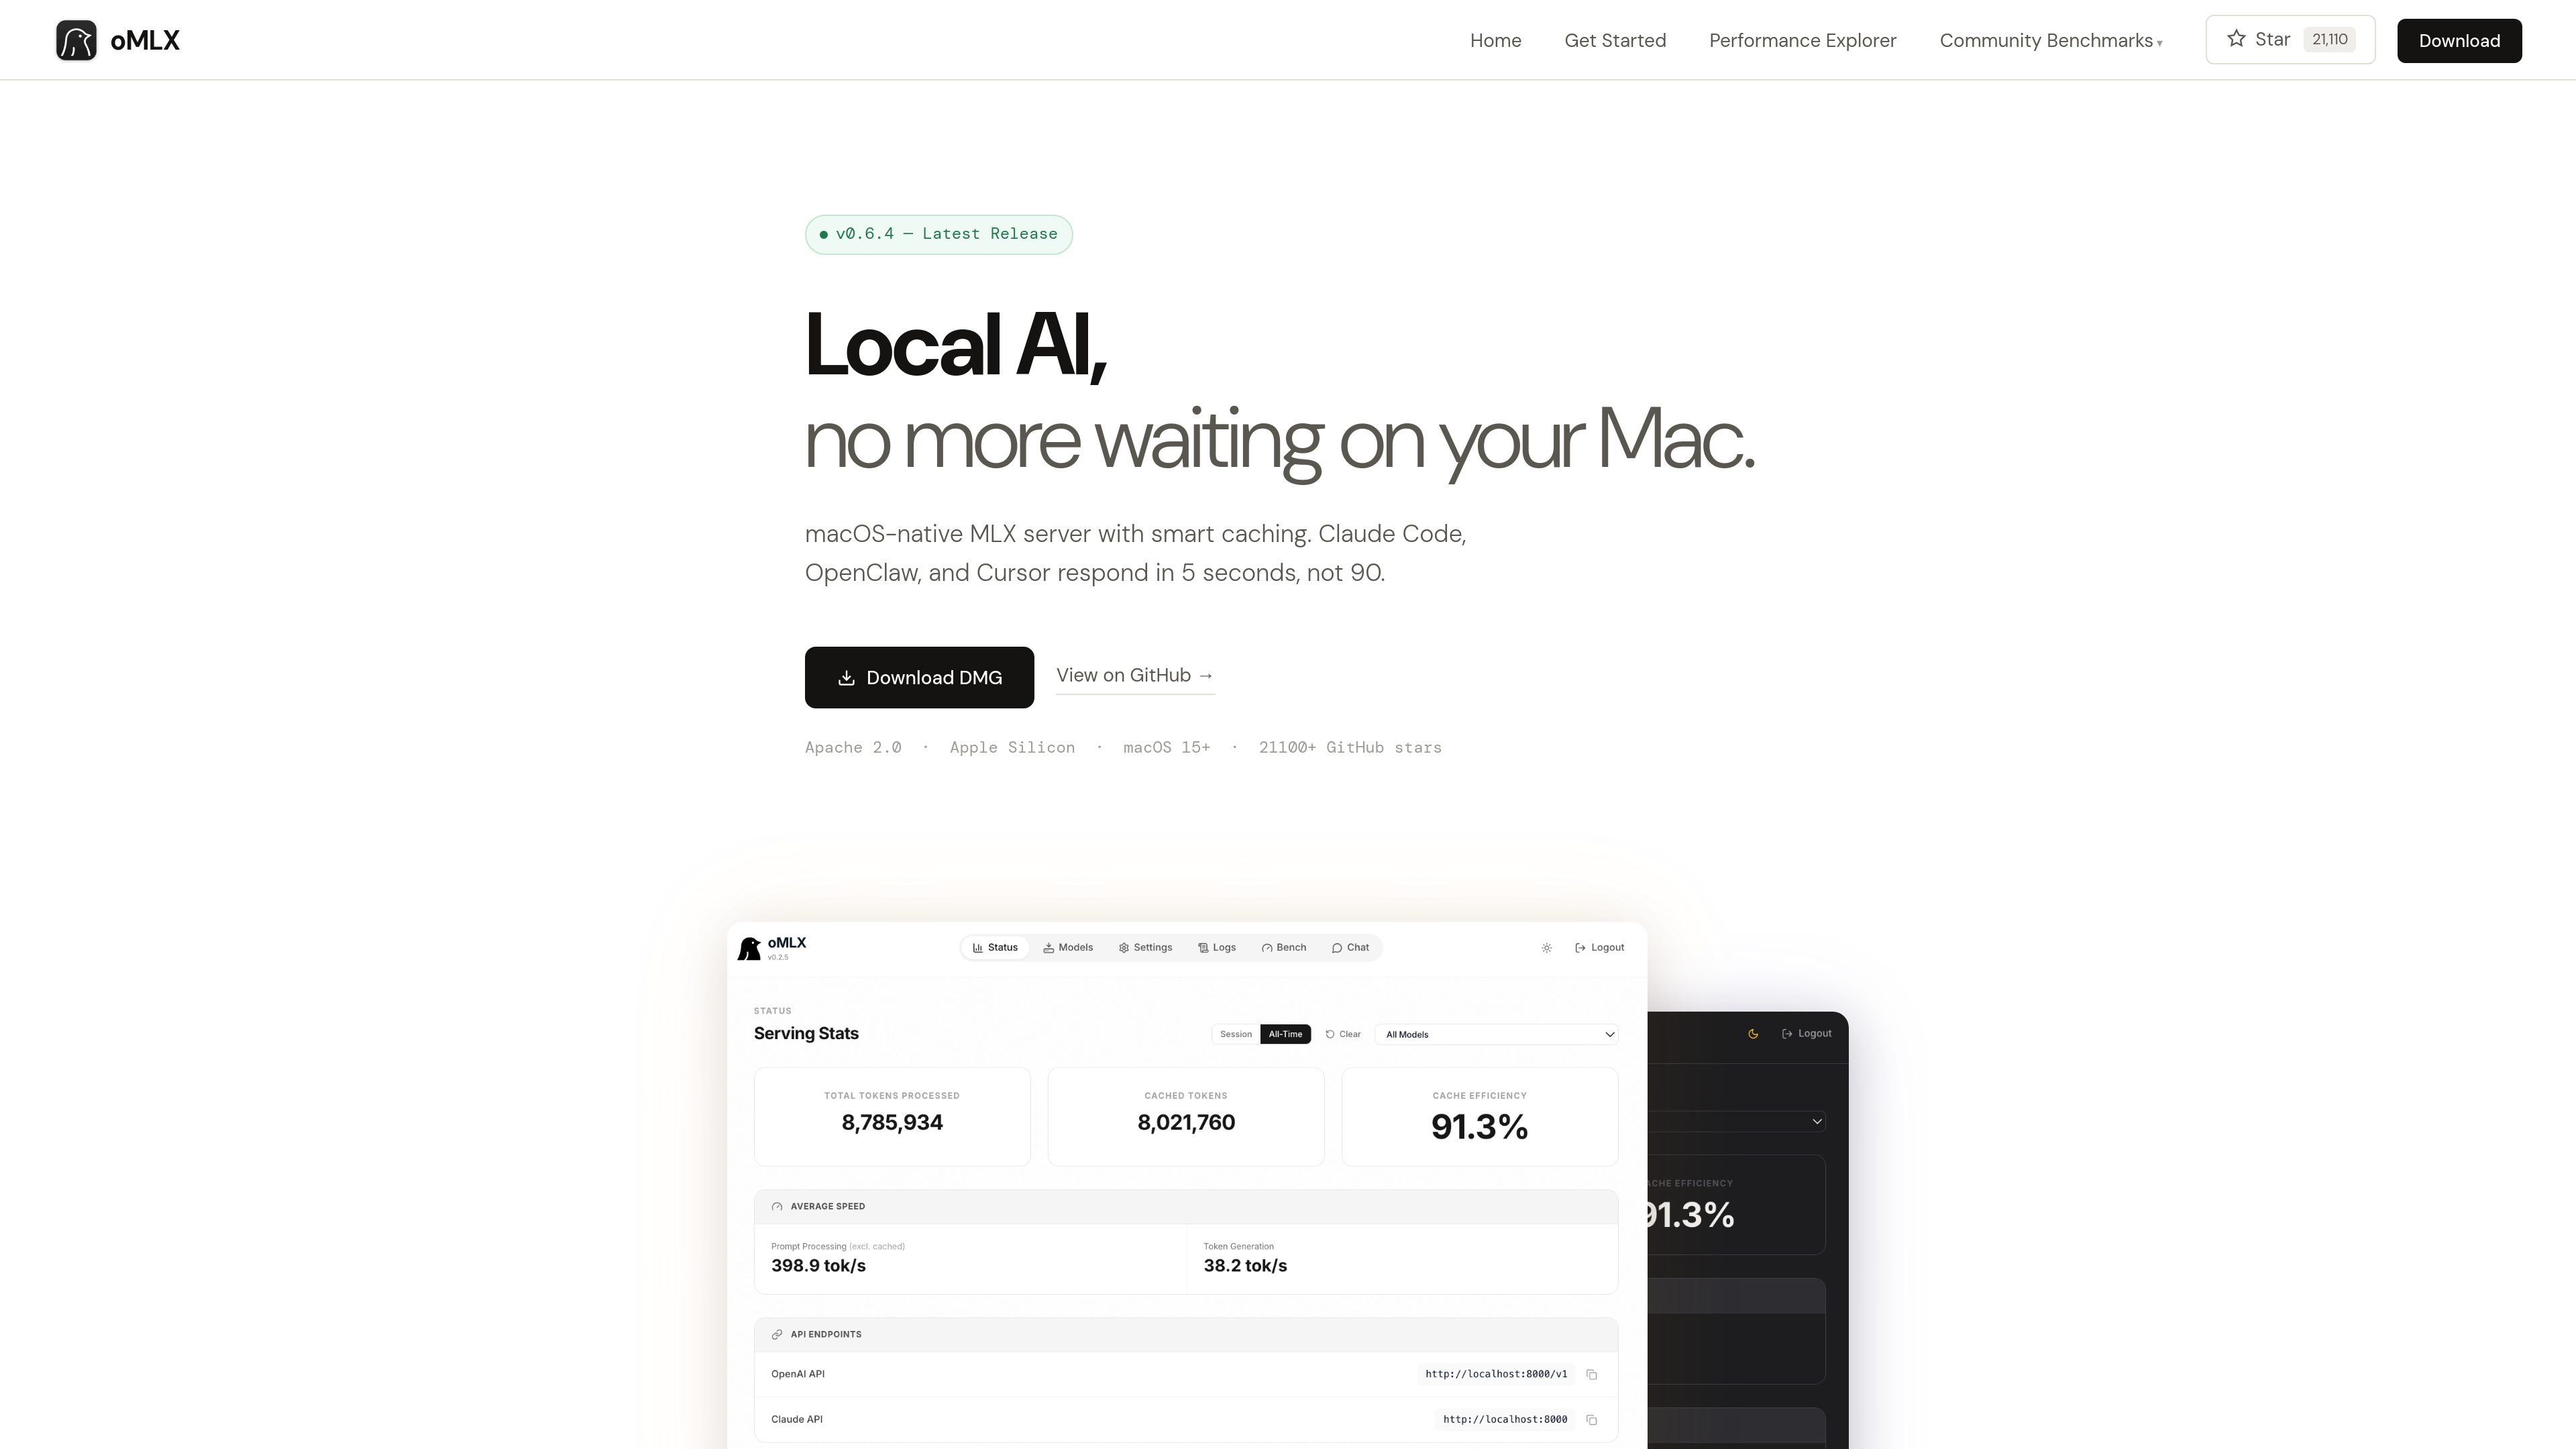
oMLXは、Apple Silicon搭載MacでローカルLLMを使うためのネイティブmacOS推論サーバーです。MLX上に構築されており、セッション中にコーディングエージェントがコンテキストを無効化したときに発生する、繰り返しの再計算を減らすよう設計されています。
主な差別化要素はページングされたSSD KVキャッシュで、キャッシュブロックをディスクに保持することで、以前使用したプレフィックスをリクエスト間やサーバー再起動後でもすばやく復元できます。さらに、連続バッチ処理、マルチモデル提供、ローカルツールやクライアント向けのOpenAI互換・Anthropic互換APIも備えています。
oMLXはKVキャッシュブロックをRAMにのみ保持する代わりに、safetensors形式でSSD上に保存します。ホットブロックはメモリに残り、コールドブロックはディスクへ移動し、以前に見たプレフィックスはリクエスト間やサーバー再起動後でも復元できます。
サーバーはmlx-lmのBatchGeneratorを通じて同時リクエストを処理するため、複数の生成処理が1つのリクエストの後ろで待つ必要がありません。ホームページでは、8×の同時実行で最大4.14×の高速化が報告されています。
oMLXには、サーバーの開始、停止、監視のためのネイティブmacOSメニューバーアプリが含まれています。付属のダッシュボードはモデル管理、チャット、リアルタイムメトリクスをサポートし、アプリは署名済み、Notarization済み、自動更新対応です。
ダッシュボードでは、LLM、VLM、embedding、rerankerを含む複数のモデル種類を同時に提供できます。メモリが逼迫した場合のLRU退避や、インターフェースからのモデル閲覧/ダウンロードにも対応しています。
oMLXは、/v1/chat/completionsや/v1/messagesを含むOpenAI互換およびAnthropic互換の両方のAPIを公開します。サイトによると、Claude Code、OpenClaw、Cursor、その他のOpenAI互換クライアント向けのドロップインバックエンドとして動作できます。
本製品は、JSON、Qwen、Gemma、GLM、MiniMaxなどの主要なツール呼び出し形式に加え、MCP統合と、出力が大きすぎる場合のツール結果のトリミング設定をサポートします。
以前のコンテキストを何度も見直すコーディング支援ツールのローカルバックエンドとしてoMLXを使います。SSD対応キャッシュは、エージェントが進路を修正するたびに再計算するのではなく、過去のプレフィックスを保持して復元するよう設計されています。
ドロップインAPI対応を使って、Claude Code、OpenClaw、CursorをローカルmacOS推論サーバーに接続します。サイトによると、ダッシュボードは各ツール向けの正確な設定コマンドを生成できます。
チャット用のLLM、画像対応作業用のVLM、検索タスク用のembeddingやrerankerモデルなど、複数のモデル種類を同じマシンで提供します。ダッシュボードでは、モデルの閲覧、ダウンロード、管理を一元的に行えます。
メニューバーアプリとWebダッシュボードを使って、別のデスクトップアプリに切り替えることなく、サーバーの起動、状態監視、リアルタイムメトリクスの確認を行えます。これは、作業中もローカル推論を常に利用できるようにしたい人に便利です。
すでにHugging FaceのキャッシュフォルダやLM Studioディレクトリにあるモデルを再利用し、追加のダウンロードなしでローカル提供します。これにより、ディスク上にすでにローカルモデルのライブラリを持つユーザーにもoMLXは適しています。
oMLXはMLXで構築されたネイティブmacOS推論サーバーです。Claude Code、OpenClaw、Cursorなどのツールがローカルのバックエンドに接続できるよう、OpenAI互換およびAnthropic互換のエンドポイントを公開します。
ソースによると、oMLXはmacOS 15+で動作するApple Silicon搭載Macをサポートします。最小RAMは16GBで、より大きなモデルを快適に使うには64GB以上が推奨されています。
はい。ホームページでは、oMLXはClaude Code、OpenClaw、Cursor向けのドロップインバックエンドとして動作し、localhost:8000上の任意のOpenAI互換クライアントでも使用できると説明されています。
いいえ。FAQによると、oMLXは標準のHugging Faceキャッシュを読み込むため、共有キャッシュの場所にすでにダウンロード済みのモデルを再ダウンロードせずに再利用できます。LM Studioのフォルダやカスタムディレクトリにも対応しています。
サイトによると、Hugging Face上のMLX形式のモデルであれば、LLM、VLM、embedding、rerankerモデルを含めてサポートされており、いくつかの推論モデル形式も自動処理されます。

ByteAskは、C/C++向けのターミナル起点AIコーディングエージェント。リポジトリを編集し、コンパイラやデバッガ、サニタイザ、テストで変更を検証してから差分を表示。無料枠あり。

CreateOS Sandboxは、FirecrackerマイクロVM上でコードやエージェントのワークロードを実行できる分離型コンピュート環境です。SDK、CLI、MCPで制御可能。

hobは、エージェントのセッション、ターミナル、履歴、後続作業を、既存のツールやプロバイダーに合わせて整理できる独立したコーディングエージェント向けワークスペース。ローカルでの制御を重視する開発者に最適。

Manta AIは、URLからアプリの挙動を把握し、回帰を検出し、スクリプトやセレクタ管理なしでテストを生成できる自律型Webアプリテストツールです。

SonOfは、リポジトリとPMツールに接続し、コードベースと周辺の製品コンテキストを監査して、承認済みの作業をシニアエンジニアのレビュー付きで公開済みチケットに変えます。

Ghostは、チャット、コード生成、コマンドラインでのタスク実行に対応したターミナル向けAIアシスタントです。無料モデルを同梱し、Linux、macOS、Windowsで使えます。オープンソースです。