
分页式 SSD KV 缓存
oMLX 会将 KV 缓存块以 safetensors 格式存储到 SSD 上,而不是只保留在 RAM 中。热块保留在内存里,冷块移到磁盘上,之前见过的前缀可在请求之间以及服务器重启后恢复。
oMLX 是一款适用于 Apple Silicon Mac 本地 LLM 使用的原生 macOS 推理服务器。它基于 MLX 构建,旨在减少编码代理在会话中使上下文失效时反复重新计算的开销。
它的主要差异化在于分页式 SSD KV 缓存:该功能将缓存块持久化到磁盘,因此之前使用过的前缀可以在多个请求之间,甚至在服务器重启后快速恢复。该产品还加入了连续批处理、多模型服务,以及兼容 OpenAI 和 Anthropic 的 API,供本地工具和客户端使用。
oMLX 会将 KV 缓存块以 safetensors 格式存储到 SSD 上,而不是只保留在 RAM 中。热块保留在内存里,冷块移到磁盘上,之前见过的前缀可在请求之间以及服务器重启后恢复。
服务器通过 mlx-lm 的 BatchGenerator 处理并发请求,因此多个生成任务不必在单个请求后排队等待。主页显示在 8× 并发下最高可达 4.14× 的加速。
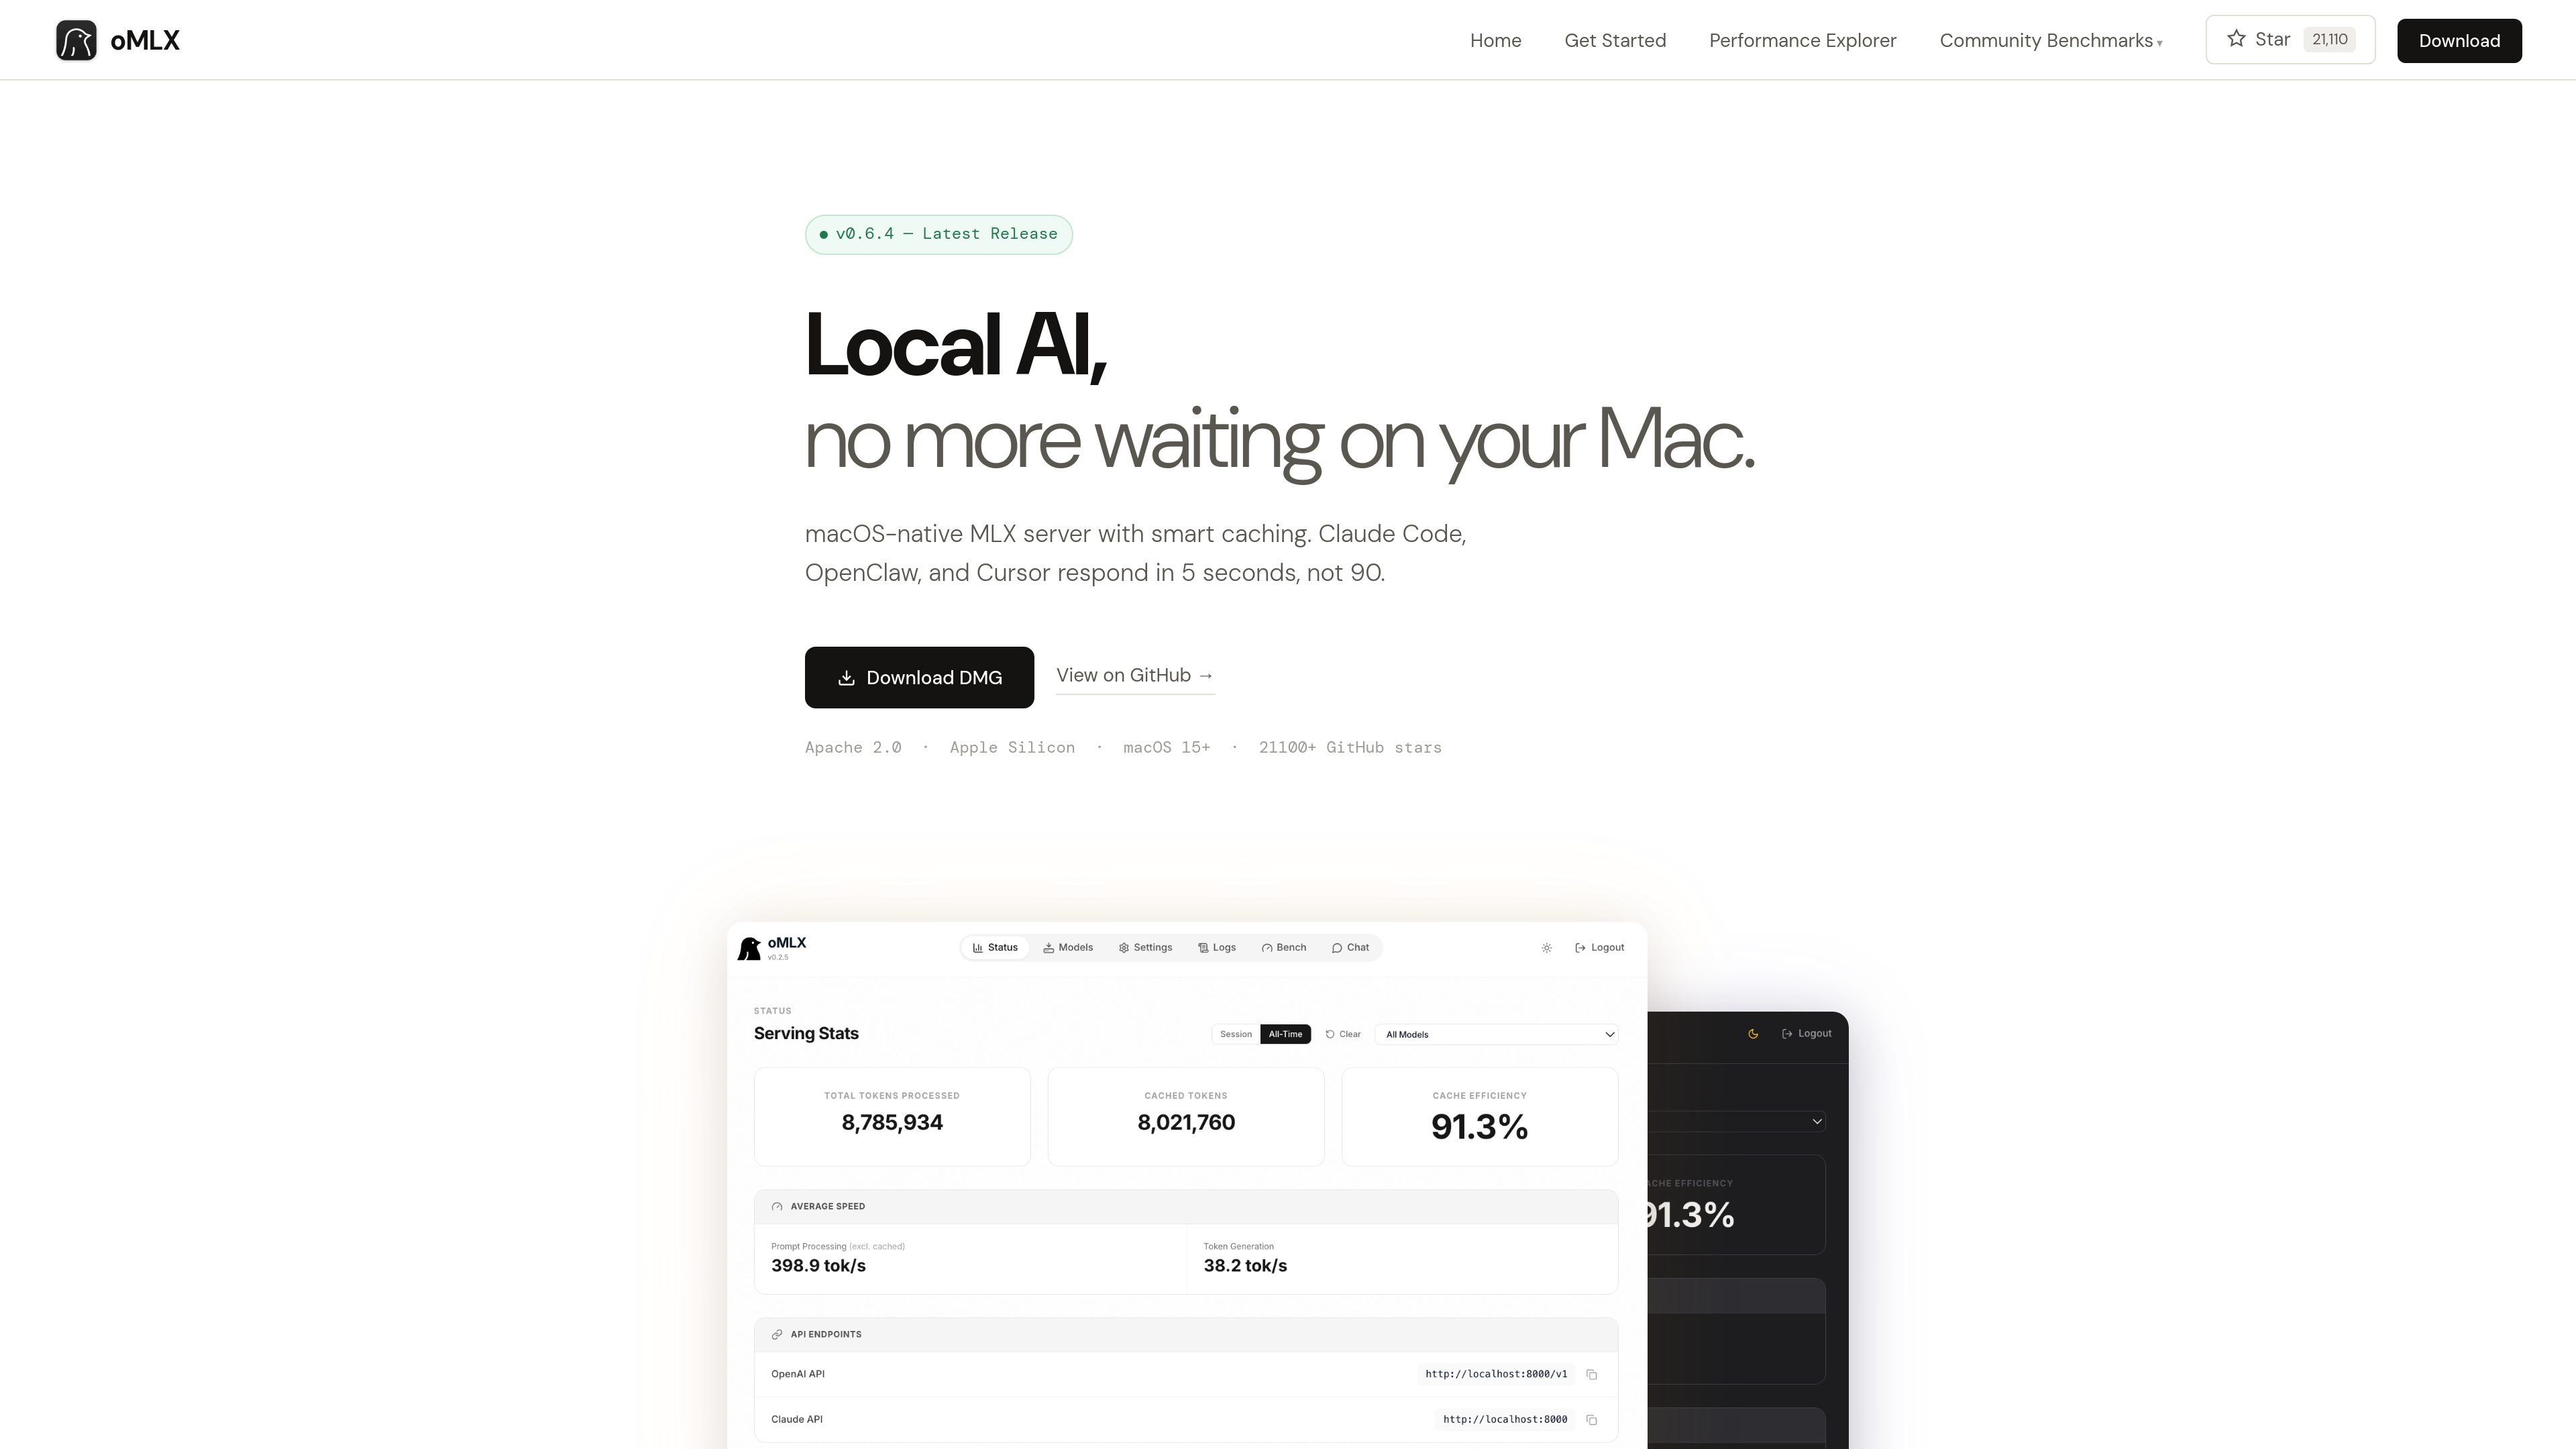
oMLX 包含一个原生 macOS 菜单栏应用,用于启动、停止和监控服务器。配套仪表板支持模型管理、聊天和实时指标,而且应用经过签名、公证并支持自动更新。
仪表板可同时提供多种模型类型,包括 LLM、VLM、embedding 和 reranker。它还支持在内存紧张时进行 LRU 淘汰,并可通过界面浏览和下载模型。
oMLX 同时提供兼容 OpenAI 和兼容 Anthropic 的 API,包括 /v1/chat/completions 和 /v1/messages。网站称它可作为 Claude Code、OpenClaw、Cursor 以及其他 OpenAI 兼容客户端的即插即用后端。
该产品支持 JSON、Qwen、Gemma、GLM 和 MiniMax 等主流工具调用格式,还支持 MCP 集成,以及针对过大输出的可配置工具结果裁剪。
将 oMLX 用作会反复回到早期上下文的编码助手的本地后端。SSD 支持的缓存旨在保留并恢复先前的前缀,而不是在代理每次调整路径时都重新计算。
利用即插即用的 API 支持,将 Claude Code、OpenClaw 或 Cursor 连接到本地 macOS 推理服务器。网站称仪表板可以为每个工具生成精确的配置命令。
在同一台机器上同时提供多种模型类型,例如用于聊天的 LLM、用于图像感知工作的 VLM,以及用于检索任务的 embedding 或 reranker 模型。仪表板让你可以在一个地方浏览、下载和管理模型。
使用菜单栏应用和网页仪表板启动服务器、监控状态并查看实时指标,而无需切换到单独的桌面应用。对于希望本地推理在工作期间始终可用的用户来说,这很有用。
复用 Hugging Face 缓存文件夹或 LM Studio 目录中已存在的模型,然后在本地提供服务,无需再次下载。这使 oMLX 适合那些已经在磁盘上维护本地模型库的用户。
oMLX 是一款基于 MLX 的原生 macOS 推理服务器。它提供兼容 OpenAI 和 Anthropic 的端点,因此 Claude Code、OpenClaw 和 Cursor 等工具可以连接到本地后端。
源文表示 oMLX 支持运行 macOS 15+ 的 Apple Silicon Mac。最低内存为 16GB,但为了更舒适地使用更大的模型,建议使用 64GB 或更高内存。
可以。主页说明 oMLX 可作为 Claude Code、OpenClaw 和 Cursor 的即插即用后端,也可与任何使用 localhost:8000 的 OpenAI 兼容客户端配合使用。
不需要。FAQ 说明 oMLX 会读取标准的 Hugging Face 缓存,因此已经下载到共享缓存位置的模型可以直接复用,无需重新下载。它也可以识别 LM Studio 文件夹和自定义目录。
网站说明支持来自 HuggingFace 的任何 MLX 格式模型,包括 LLM、VLM、embedding 和 reranker 模型,并会自动处理若干推理模型格式。

ByteAsk 是面向 C 和 C++ 的终端优先 AI 编码 agent,可直接编辑仓库,并在展示 diff 前用真实编译器、调试器、sanitizers 和测试验证修改。提供免费版与付费方案。

CreateOS Sandbox 是基于 Firecracker 微型虚拟机的隔离计算环境,用于运行代码和 agent 工作负载,支持私有网络、SDK、CLI 和 MCP 程序化控制。

hob 是面向编码 agent 的独立工作区,可将 agent 会话、终端、历史记录和后续工作围绕你已在用的工具与提供商有序管理,适合重视本地路由、历史和工作区结构控制的开发者。

Manta AI 是面向团队的自治式网页应用测试工具,可从 URL 自动探索应用、映射行为、捕捉回归,并用自然语言生成测试,无需脚本或维护选择器。

SonOf 连接你的代码仓库和 PM 工具,审计代码库与产品上下文,将已批准工作转为可交付工单,并由资深工程复审,适合缺少完整团队的创始人和技术负责人。

Ghost 是一款基于终端的 AI 助手,可在命令行中聊天、生成代码并运行任务。内置免费模型,支持 Linux、macOS 和 Windows,且为开源项目。