

基于浏览器的硬件检测
直接在浏览器中检测可用的硬件信号,并利用这些信息估算本机可以运行哪些本地模型。
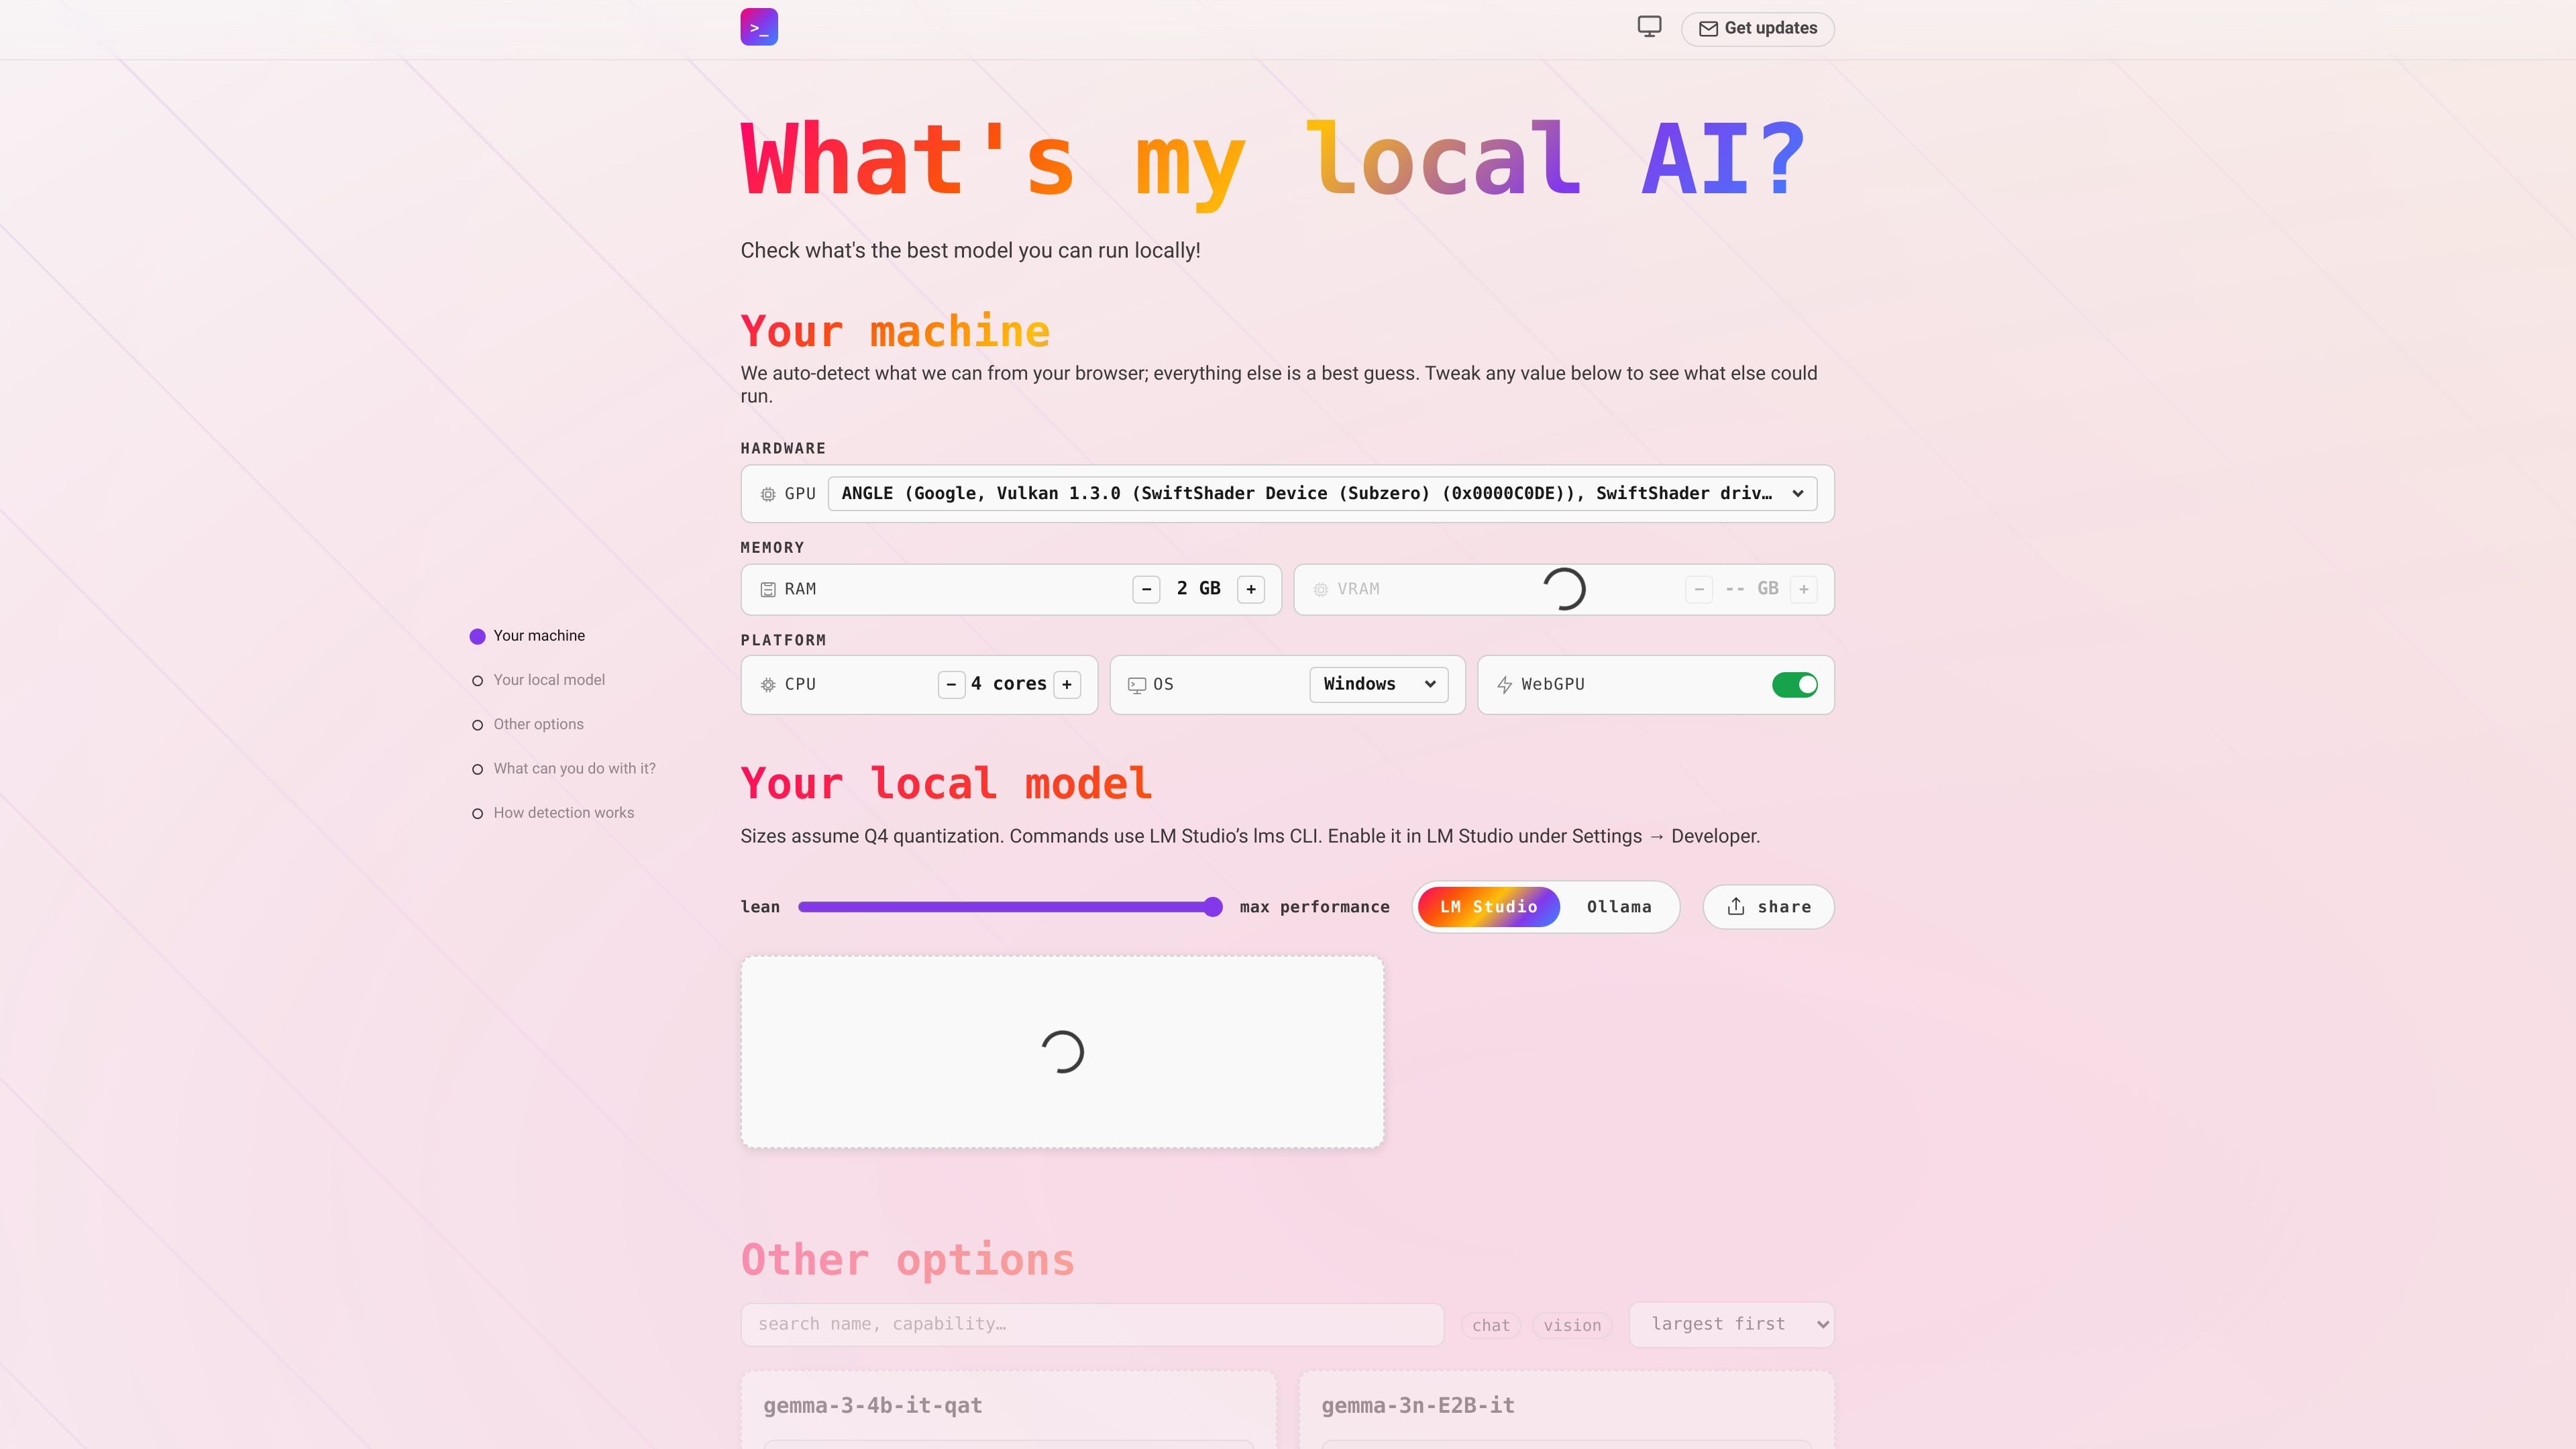
What's my local AI? 是一款面向在自己硬件上本地运行 AI 的用户的浏览器式模型选择器。它会在浏览器中尽可能检测机器信息,然后建议哪些本地模型可以与 Ollama 或 LM Studio 等工具一起运行。
页面强调检测会在本地完成,因此不会上传任何内容。用户还可以手动调整硬件数值,查看推荐模型集合如何变化,这使它在安装或尝试模型之前用于比较选项很有帮助。
直接在浏览器中检测可用的硬件信号,并利用这些信息估算本机可以运行哪些本地模型。
为包括 Ollama 和 LM Studio 在内的本地运行时显示模型推荐,帮助用户缩小到适合其配置的模型范围。
允许用户编辑已检测到的数值,例如 GPU、RAM、VRAM、CPU、OS 和 WebGPU,以便测试不同的硬件假设。
将选项从轻量到最高性能进行排序,并提供“最大优先”“最小优先”和按字母顺序等其他排序视图。
在模型属于紧配情况时进行提示,并标记即使最小列出的模型也需要约 2 GB 的情况,帮助用户判断余量。
在安装任何东西之前,先使用检测到的硬件以及你想做的任何手动调整,选择适合笔记本电脑或台式机的本地模型。
当你希望内容保留在自己的机器上时,对本地 AI 选项进行比较,用于私密起草、翻译或头脑风暴。
在可能需要离线工作的硬件上测试离线编码辅助,例如旅行途中或低连接环境中。
在决定是否值得为 API 付费之前,先在自己的机器上试用开源权重的推理、视觉或工具使用模型。
通过更改规格并比较推荐结果,用模型列表帮助建立对不同模型大小在硬件上表现差异的直觉。
它在启用 JavaScript 的浏览器中运行。页面说明检测会在本地进行,因此在看到推荐结果之前不会有任何上传。
页面明确提到 Ollama 和 LM Studio 是它帮助你选择模型的本地运行时。
来源说明它会从浏览器中自动检测可获取的信息,并在你想调整估算时,让你修改 GPU、RAM、VRAM、CPU、OS 以及 WebGPU 状态等数值。
这个页面面向那些为私密写作、离线编码、阅读自己的文件、进行零成本实验,或了解模型大小在硬件上表现如何而选择模型的人。
来源未列出定价信息,因此此处页面内容无法确认该产品是免费、付费,还是两者都有。

AakarDev AI 帮助团队在一个仪表板中管理 AI provider 访问、项目级设置、日志和分析,支持 BYOK 工作流,并涵盖 OpenAI、Google Gemini、Anthropic、Groq、Mistral AI 和 Perplexity AI。

ByteAsk 是面向 C 和 C++ 的终端优先 AI 编码 agent,可直接编辑仓库,并在展示 diff 前用真实编译器、调试器、sanitizers 和测试验证修改。提供免费版与付费方案。

CreateOS Sandbox 是基于 Firecracker 微型虚拟机的隔离计算环境,用于运行代码和 agent 工作负载,支持私有网络、SDK、CLI 和 MCP 程序化控制。

hob 是面向编码 agent 的独立工作区,可将 agent 会话、终端、历史记录和后续工作围绕你已在用的工具与提供商有序管理,适合重视本地路由、历史和工作区结构控制的开发者。

Ably Chat 是用于构建自定义实时聊天应用的 chat API 平台,支持房间消息、输入指示、在线状态、表情回应与消息更新,并提供按使用量计费选项。

Manta AI 是面向团队的自治式网页应用测试工具,可从 URL 自动探索应用、映射行为、捕捉回归,并用自然语言生成测试,无需脚本或维护选择器。