
構造化されたドメインモデル
doc_types、entities、relationships としてドメインをモデル化し、brain にフラットなプロンプトや場当たり的なメモではない定義済みの構造を持たせます。

Open Indexは、AIエージェント向けのオープンソース構造化コンテキスト層。検索可能なドメイン別の知識基盤を構築し、ローカルまたはHTTPで更新・提供できます。
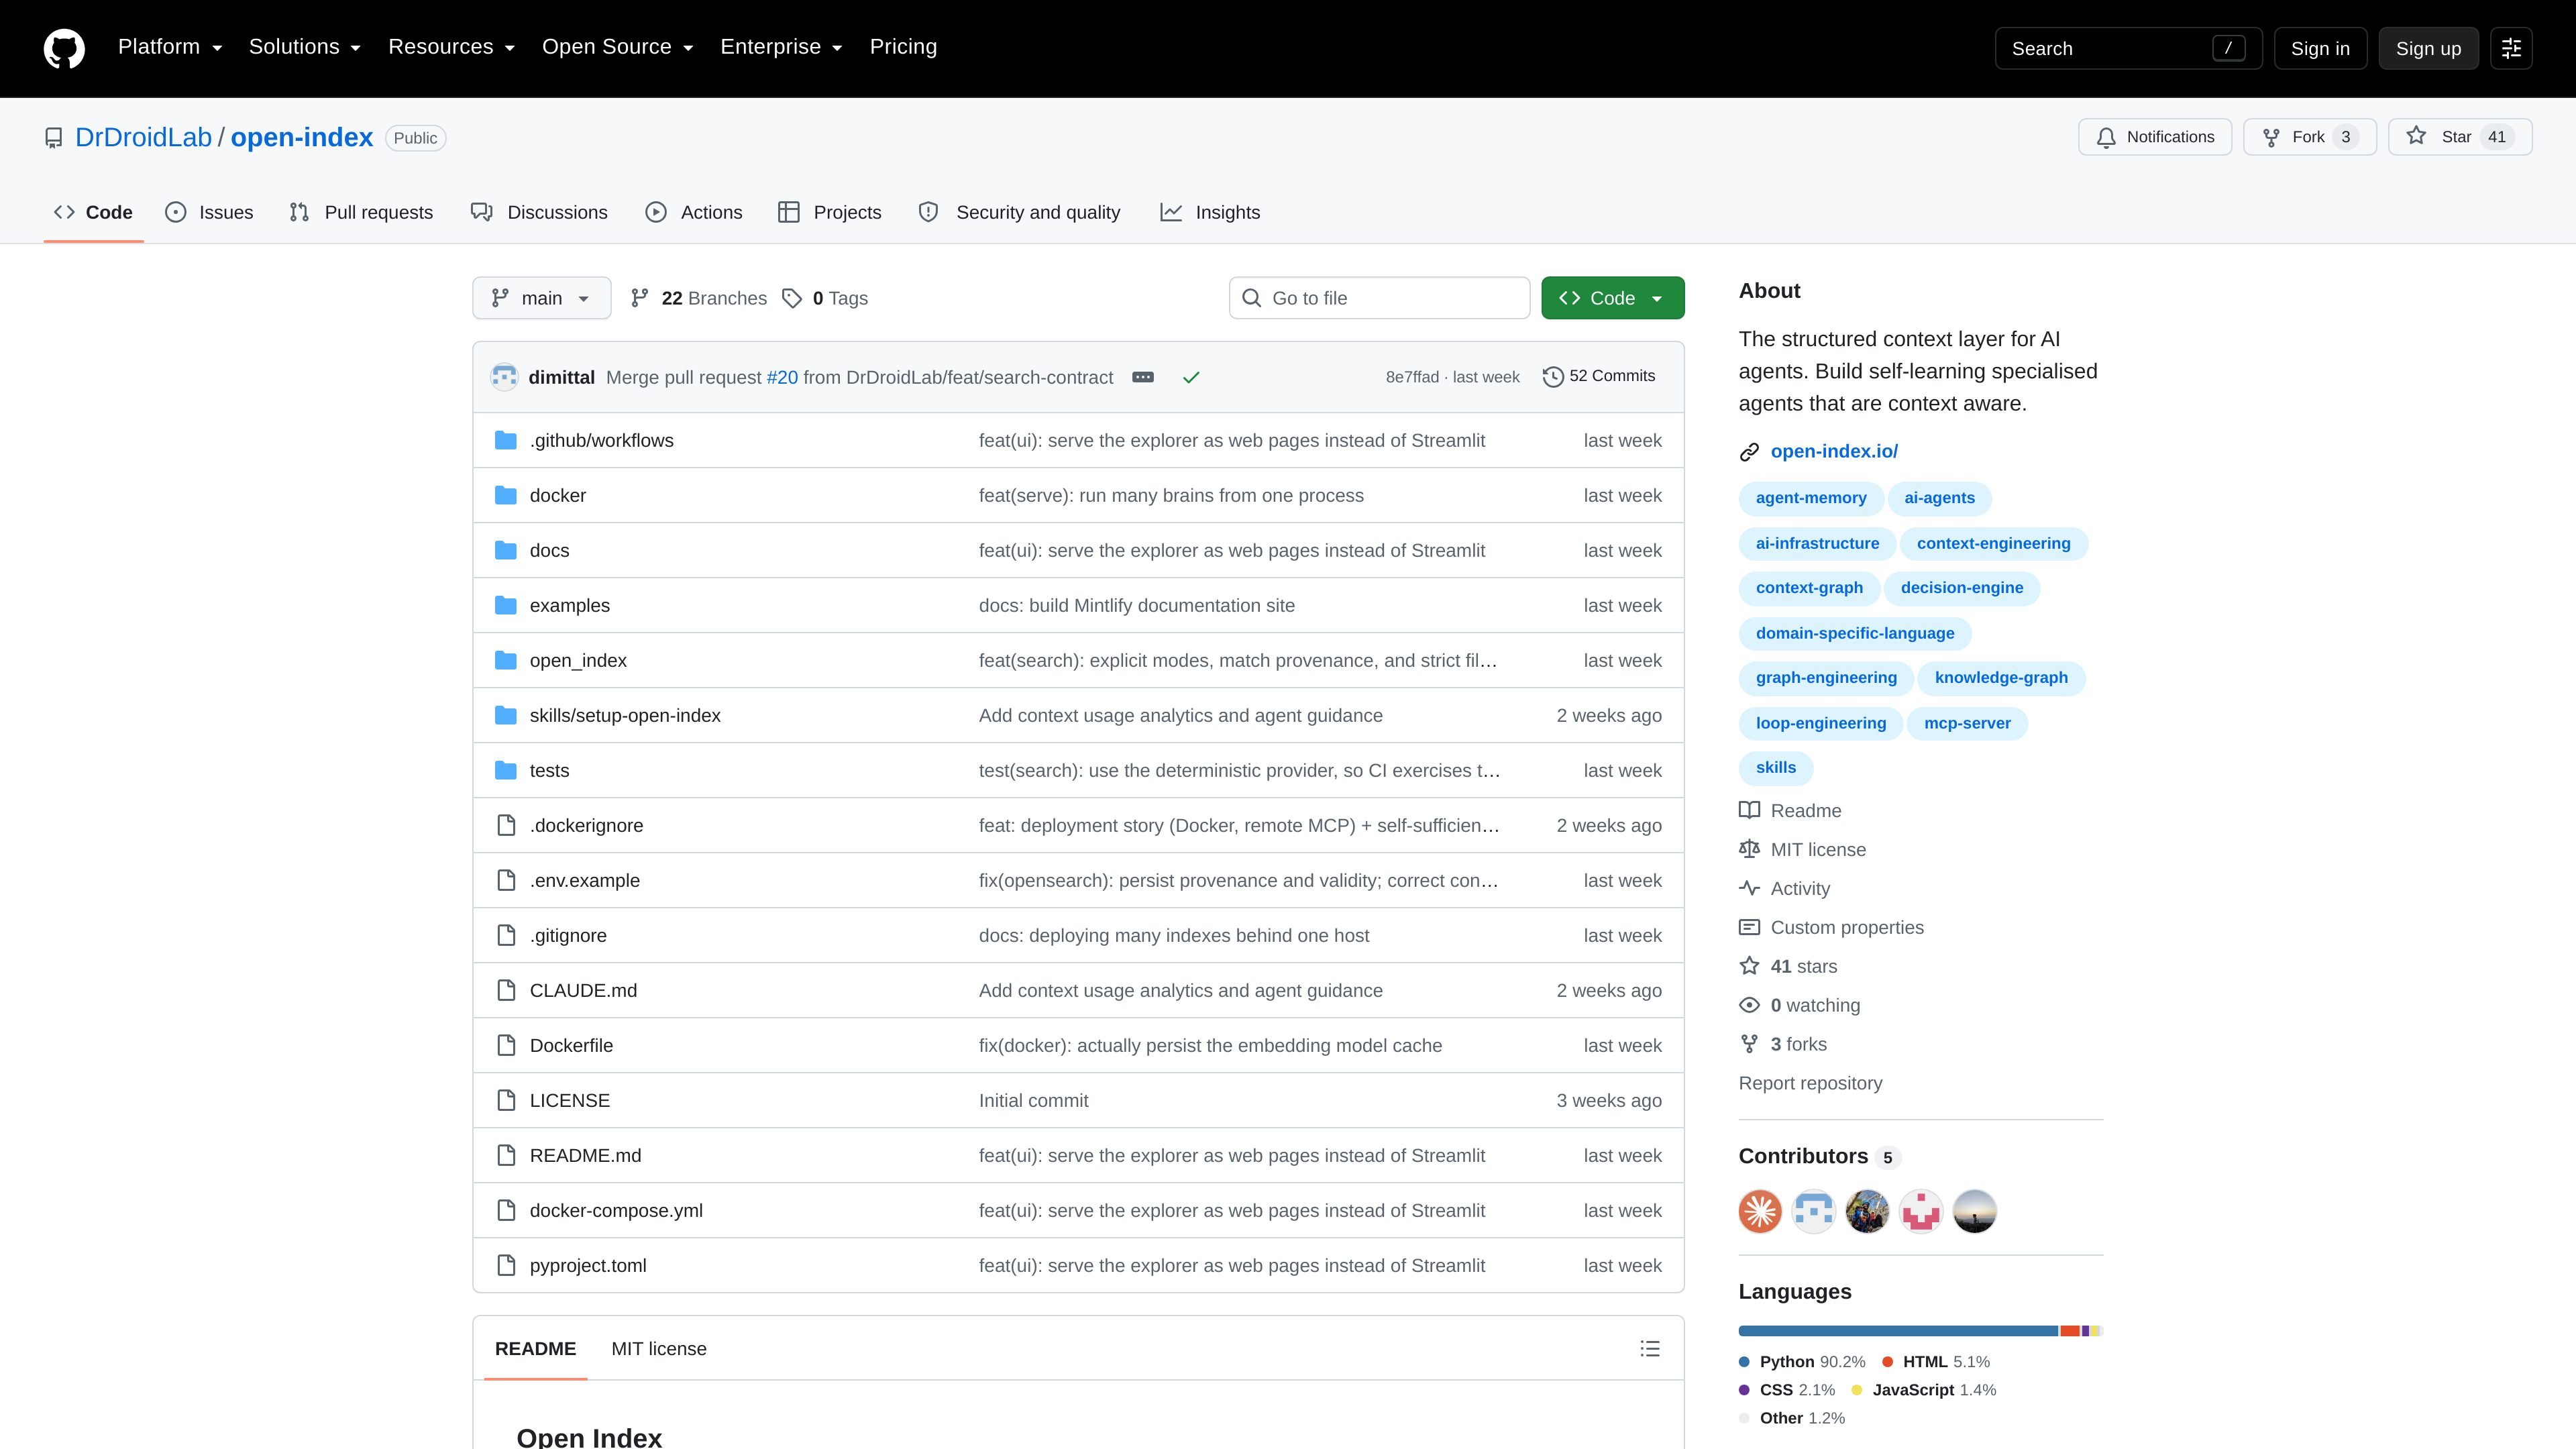
Open Index は、AI エージェント向けの構造化コンテキスト層を構築するためのオープンソースツールです。ドメインを doc types、entities、relationships の集合として定義し、そのデータを保存・検索することで、エージェントが非構造化のプロンプトやドキュメントの詰め込みよりも正確な情報を扱えるようにします。
このプロジェクトは、ローカルで作成でき、stdio または HTTP 経由でエージェントに提供でき、手動編集やコネクタ駆動の取り込みによって最新状態を保てる “brain” を中心に設計されています。既定の構成では SQLite と FTS5 を使用し、リモートまたは複数ライターのデプロイで別の検索バックエンドが必要な場合は OpenSearch を利用できます。
doc_types、entities、relationships としてドメインをモデル化し、brain にフラットなプロンプトや場当たり的なメモではない定義済みの構造を持たせます。
SQLite パスではあいまい検索や টাইポ耐性のある検索、OpenSearch ではネイティブな k-NN 検索をサポートし、ターミナルまたは MCP レイヤー経由でエンティティを検索できます。
doc type ごとにファイルバックまたはインデックスバックのストレージを選べるため、キュレーションされたコンテンツとコネクタ由来のデータを分けながら、適切な場所に異なる種類のデータを保持できます。
MCP ベースの取り込みを含むコネクタを実行して外部データを同期し、組み込みの run コマンドでコネクタ実行をスケジュールできます。
stdio または HTTP で brain をエージェントに公開でき、リモート HTTP 提供では bearer-token 認証を利用できるほか、エージェント設定用の MCP ブロックを出力する config コマンドもあります。
スキーマ、brain 設定、エンティティファイルを検証し、How to use、Schema、Explore、Map、Analytics、Jobs の各ビューを備えた UI で確認できます。
サポートチームは、製品、問題、セグメント、コメントをモデル化して、エージェントが既知の問題を検索し、新しい事例が入るたびにサポート知識を最新に保てるようにできます。
インフラチームは、サービス、ダッシュボード、ランブック、アラートを brain に保存し、トラブルシューティング中や運用コンテキストの更新時にエージェントが問い合わせできるようにできます。
営業またはアカウント管理のワークフローでは、顧客、商談、関連レコードをマッピングして、散在するメモではなく構造化されたパイプラインに基づいてエージェントが作業できます。
個人開発者は、リポジトリ内でローカルの brain を起動し、それをインデックス化して、別のサービスをホストせずに Claude Code や他の MCP クライアントを接続できます。
Open Indexは、AIエージェント向けのコンテキスト層です。ドメインの概念を構造化されたエンティティとして保存し、それらを検索できるようにして、同じ brain をエージェントが読み書きできる MCP サーバー経由で公開します。
リポジトリには、ローカルの stdio モード、リモートの HTTP モード、そして Docker ベースのデプロイ経路が示されています。デプロイガイドでは、ローカル構成は通常 1 台のマシン上で単一のエージェントに使われ、リモート構成はチーム、クラウド上のエージェント、または 1 つの brain を共有する CI に適していると説明されています。
ドキュメントでは、読み取りと書き込みがデフォルトの MCP モードとして説明されています。エージェントは navigation_guidelines()、search_brain()、get_entity() でコンテキストを取得でき、put_entity() と create_doc_type() で brain を更新できます。
はい。ドキュメントによると、open-index init は Claude Code 向けの利便性として .mcp.json、CLAUDE.md、編集用スキルを生成し、プロジェクトは他のランタイム向けに移植可能な Agent Skills ファイルも提供しています。
このプロジェクトは既定で SQLite と FTS5 を使用し、リモート構成や複数ライター構成では OpenSearch に切り替えられます。デプロイガイドでは、SQLite はシングルライターであり、複数エージェントが書き込む場合や大規模なセマンティック検索ワークロードでは OpenSearch が選択肢になると説明されています。

garden-mdは、会議の文字起こしをローカルの社内Wikiに変換するオープンソースのNode.js CLIです。本文を保持したまま、文字起こし同士のエンティティをリンクして閲覧しやすいWikiを生成します。

Goldfishは、Mac上の文脈を活用して返信、執筆、要約、作業継続を支援するmacOS向けAIメモリアプリです。メモリはMac内に保存され、あなたらしい文体で書けます。
Lassoは、カタログ情報の拡充、仕入先ファイルの処理、商品コンテンツの生成、競合監視に使えるecommerce商品データプラットフォームです。REST API、SDK、MCP serverも搭載。

CreateOS Sandboxは、FirecrackerマイクロVM上でコードやエージェントのワークロードを実行できる分離型コンピュート環境です。SDK、CLI、MCPで制御可能。

ArtDeckは、iPhone、iPad、Mac向けのビジュアル参考ボードアプリ。素材を1枚のキャンバスに集約し、ToolBoxレンズでオフラインでも観察できます。iCloud同期は任意、買い切りでアカウント不要。

Codex Plugins は、再利用可能なスキル、アプリ連携、MCPサーバーを Codex app や Codex CLI で使えるワークフローにまとめます。接続サービスの作業や共有チームワークフローを拡張できます。